Stable Diffusion: fundamentos, arquitectura y aplicaciones de un modelo generativo de imágenes
Introducción
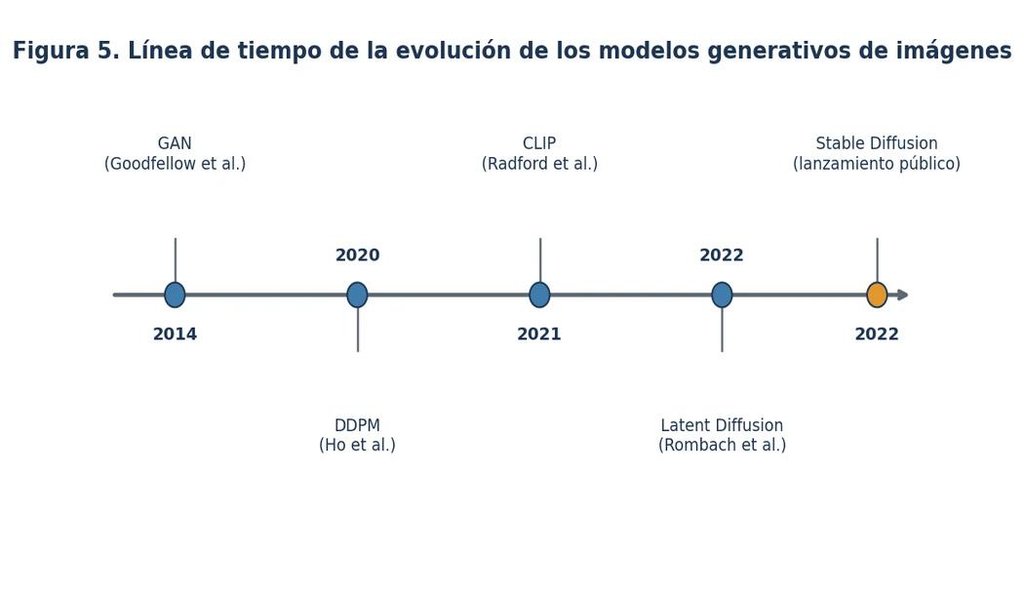
En los últimos años, la inteligencia artificial generativa ha transformado la forma en que se produce contenido visual. Entre las tecnologías que han impulsado este cambio se encuentra Stable Diffusion, un modelo de difusión latente capaz de generar imágenes fotorrealistas o estilizadas a partir de descripciones textuales. Desarrollado por investigadores de la Universidad Ludwig Maximilian de Múnich junto con Runway y publicado bajo el nombre de Latent Diffusion Models, el sistema fue popularizado comercialmente por la empresa Stability AI, que lo liberó al público en agosto de 2022 (Rombach et al., 2022; Stability AI, 2022).
A diferencia de otros modelos de generación de imágenes que operan directamente sobre los píxeles, Stable Diffusion introdujo una innovación clave: realizar el proceso de difusión en un espacio latente comprimido, lo que redujo drásticamente el costo computacional sin sacrificar la calidad visual (Rombach et al., 2022). Este artículo describe los fundamentos teóricos del modelo, su arquitectura, el papel del condicionamiento textual, sus principales aplicaciones y las limitaciones éticas asociadas a su uso.
¿Qué es Stable Diffusion?
Stable Diffusion es un modelo de aprendizaje profundo de tipo texto a imagen (text-to-image) que pertenece a la familia de los modelos de difusión probabilísticos. Su función principal consiste en recibir una descripción en lenguaje natural conocida como prompt y generar una imagen que corresponda semánticamente a dicha descripción. El modelo también permite tareas relacionadas como la edición de imágenes (inpainting), la transformación de imagen a imagen y el aumento de resolución (Stability AI, 2022).
Lo que distingue a Stable Diffusion de propuestas anteriores como DALL·E 2 o Imagen es su naturaleza de código abierto y su eficiencia: el modelo puede ejecutarse en tarjetas gráficas de consumo con alrededor de 10 gigabytes de memoria de video, generando imágenes de 512 × 512 píxeles en pocos segundos (Stability AI, 2022). Esta accesibilidad favoreció una rápida adopción por parte de comunidades de desarrolladores, artistas digitales e investigadores en todo el mundo.
Fundamentos del proceso de Stable Diffusion
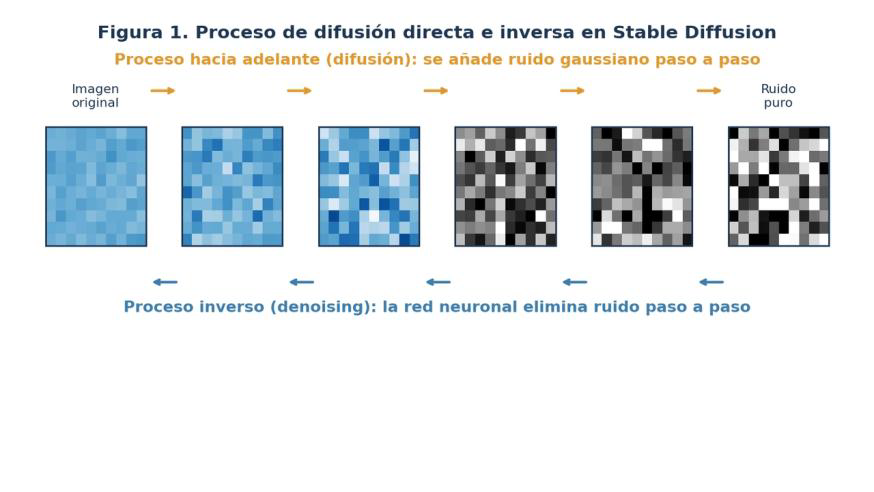
El concepto central detrás de Stable Diffusion proviene de los modelos probabilísticos de difusión de eliminación de ruido, o DDPM por sus siglas en inglés (Denoising Diffusion Probabilistic Models), propuestos por Ho et al. (2020). La idea consiste en dos procesos complementarios. En el proceso hacia adelante, se toma una imagen real y se le añade progresivamente ruido gaussiano en una serie de pasos discretos, hasta que la imagen se convierte, en el límite, en ruido puro e indistinguible de una distribución aleatoria.
El proceso inverso, que es el que realmente interesa para la generación, entrena a una red neuronal para revertir este deterioro: partiendo de ruido puro, el modelo predice y elimina el ruido paso a paso hasta reconstruir una imagen coherente (Ho et al., 2020). La figura 1 ilustra ambos procesos de manera esquemática.
Una vez entrenada, la red puede comenzar desde una muestra de ruido aleatorio y, guiada por información adicional como un texto descriptivo, generar una imagen completamente nueva que nunca existió en el conjunto de entrenamiento
Arquitectura del modelo Stable Diffusion
La arquitectura de Stable Diffusion combina tres componentes principales: un autoencoder variacional, una red de eliminación de ruido de tipo U-Net y un codificador de texto. El componente encargado de predecir y eliminar el ruido en cada paso es una red U-Net, una arquitectura convolucional con conexiones de salto entre las etapas de reducción y de expansión de resolución, originalmente diseñada para segmentación de imágenes médicas y adaptada aquí para tareas generativas (Rombach et al., 2022).
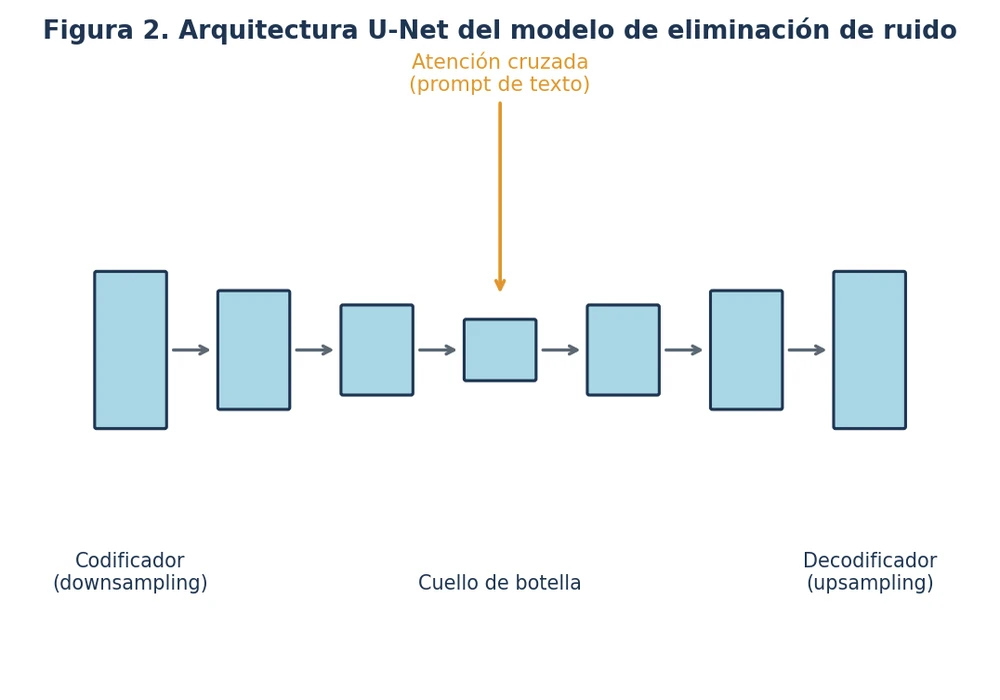
Dentro de la U-Net se insertan capas de atención cruzada (cross-attention) que permiten inyectar información proveniente de otras modalidades como el texto en cada etapa del proceso de generación. Esta característica es la que convierte a un modelo de difusión genérico en un sistema condicionable capaz de seguir instrucciones textuales específicas (Rombach et al., 2022).
El espacio latente y la eficiencia computacional
La contribución más significativa de Rombach et al. (2022) fue trasladar el proceso de difusión del espacio de píxeles a un espacio latente de menor dimensionalidad. Para ello se emplea un autoencoder previamente entrenado que comprime una imagen, por ejemplo de 512 × 512 píxeles, en una representación latente considerablemente más pequeña, del orden de 64 × 64 valores por canal.
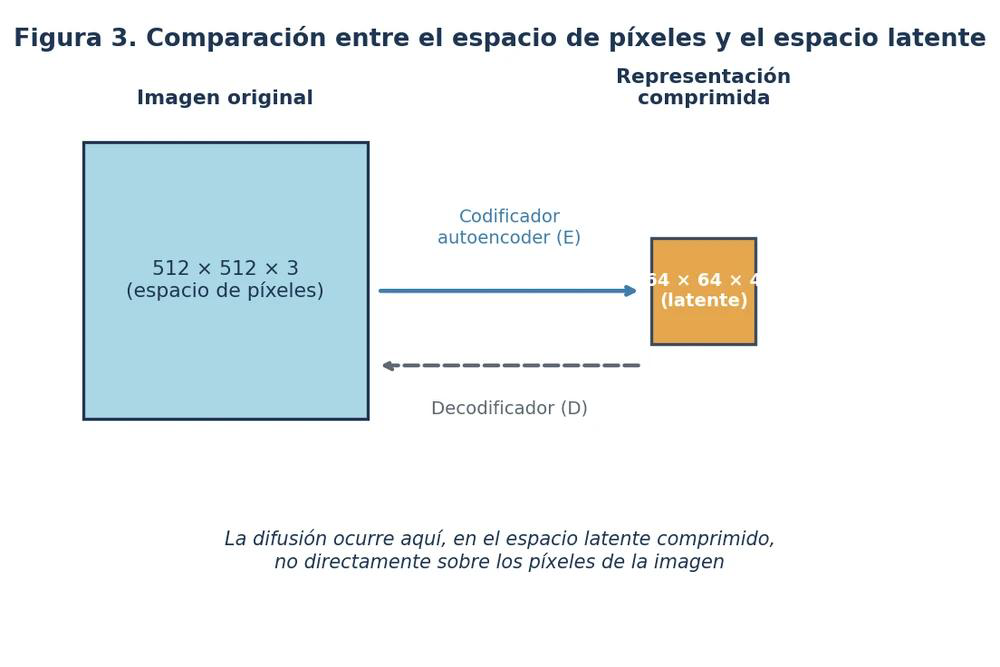
Al realizar la difusión sobre esta representación comprimida en lugar de sobre la imagen completa, el costo computacional se reduce de manera considerable, tanto en el entrenamiento como en la inferencia, sin que ello implique una pérdida perceptible de calidad visual (Rombach et al., 2022). Esta decisión de diseño es la razón por la cual el modelo puede ejecutarse en hardware de consumo, a diferencia de modelos de difusión anteriores que operaban directamente sobre píxeles y requerían cientos de días de cómputo en GPU.
Del texto a la imagen: el papel del condicionamiento
Para que el modelo pueda interpretar un prompt textual, el texto debe transformarse primero en una representación numérica que la red pueda procesar. Stable Diffusion utiliza para ello un codificador de texto basado en CLIP (Contrastive Language-Image Pre-training), un modelo entrenado para relacionar imágenes y descripciones textuales dentro de un mismo espacio semántico (Radford et al., 2021).
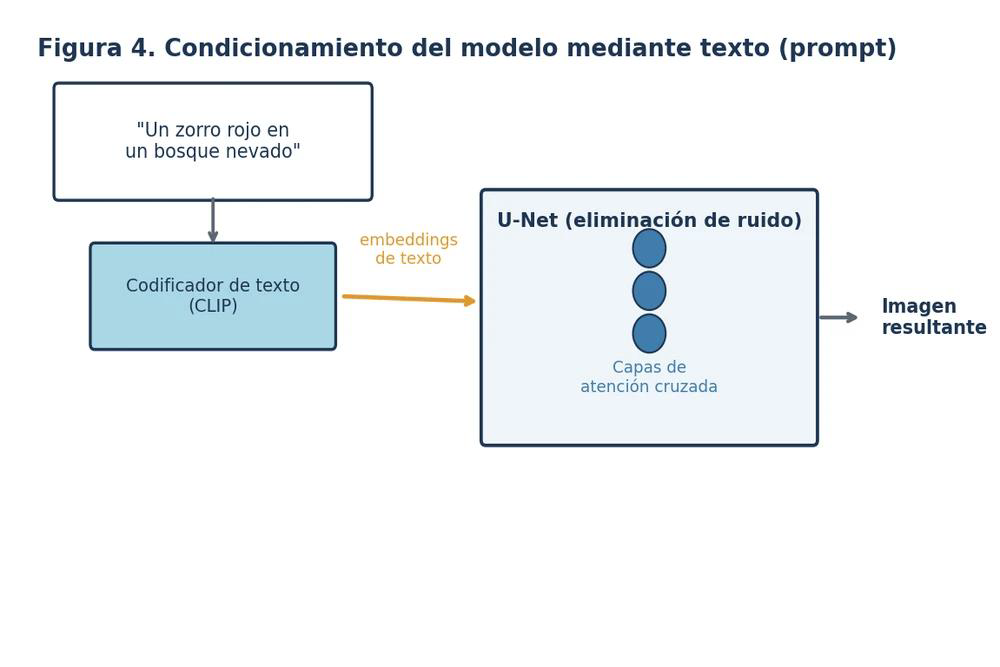
Los vectores producidos por el codificador de texto se introducen en las capas de atención cruzada de la U-Net descritas anteriormente, de modo que, en cada paso del proceso de eliminación de ruido, el modelo tiene en cuenta el significado del prompt para orientar la generación hacia una imagen coherente con la descripción proporcionada (Rombach et al., 2022). Este mecanismo también permite condicionar la generación a partir de otras señales, como mapas de segmentación o imágenes de referencia.
Aplicaciones y casos de uso
Desde su lanzamiento público, Stable Diffusion se ha utilizado en una amplia variedad de contextos. En el ámbito creativo, artistas y diseñadores lo emplean para explorar conceptos visuales, generar ilustraciones o producir material de referencia. En el diseño de productos y la publicidad, permite crear prototipos visuales rápidos sin necesidad de fotografía o ilustración tradicional.
En el terreno académico y científico, el modelo se ha utilizado como base para investigaciones en visión por computadora, restauración y superresolución de imágenes, síntesis de datos sintéticos para entrenar otros modelos, y generación de material educativo. Además, su carácter de código abierto ha propiciado el desarrollo de herramientas derivadas como ControlNet, que amplía la capacidad de condicionamiento mediante bocetos, poses o mapas de profundidad, así como interfaces de edición avanzada para inpainting y outpainting (Stability AI, 2022).
Otro ámbito de aplicación relevante es el de la industria del entretenimiento y los videojuegos, donde equipos de producción emplean el modelo para acelerar la etapa de conceptualización visual, generando múltiples variaciones de un personaje, escenario o textura en cuestión de minutos. En el sector editorial y de marketing digital, permite producir ilustraciones personalizadas para artículos, campañas publicitarias o redes sociales sin depender exclusivamente de bancos de imágenes. Finalmente, en contextos educativos, herramientas basadas en Stable Diffusion se han incorporado a talleres de alfabetización digital para introducir a estudiantes en los fundamentos de la inteligencia artificial generativa de forma práctica y accesible.
Limitaciones, consideraciones éticas y conclusión
A pesar de sus capacidades, Stable Diffusion presenta limitaciones importantes. El modelo puede generar representaciones anatómicamente incorrectas, en particular en manos y rostros, y su comportamiento depende en gran medida de los sesgos presentes en el conjunto de datos de entrenamiento, compuesto principalmente por imágenes recolectadas de internet. Esto plantea riesgos de reproducción de estereotipos culturales, de género o raciales presentes en dichos datos (Esser et al., 2020, como se citó en Rombach et al., 2022).
Asimismo, la posibilidad de generar imágenes realistas a partir de texto ha suscitado preocupaciones relacionadas con la desinformación visual, la suplantación de identidad y el uso no autorizado de estilos artísticos protegidos por derechos de autor. En respuesta, Stability AI incorporó un clasificador de seguridad y publicó el modelo bajo una licencia responsable(CreativeML Open RAIL-M), que restringe determinados usos dañinos, aunque su cumplimiento depende en gran medida de la buena fe de los usuarios. A esto se suma el debate sobre la remuneración y el consentimiento de los artistas cuyas obras formaron parte de los conjuntos de datos de entrenamiento, un tema que continúa siendo objeto de discusión legal en distintas jurisdicciones.
En conclusión, Stable Diffusion representa un avance significativo en la generación de imágenes mediante inteligencia artificial, al combinar la solidez teórica de los modelos de difusión con una arquitectura eficiente basada en espacios latentes y mecanismos de atención cruzada. Su naturaleza abierta ha democratizado el acceso a esta tecnología, pero también ha hecho más urgente la reflexión sobre su uso responsable, la transparencia de los datos de entrenamiento y el desarrollo de marcos regulatorios adecuados para acompañar su rápida evolución.
Créditos:
Autor: Rodin Andres Arenas Romero
Editor: Diego Alberto Cárdenas Mogollón
Código: UCIPT-8
Universidad: Universidad Central
Fuentes
Esser, P., Rombach, R., & Ommer, B. (2020). A note on data biases in generative models. arXiv. https://arxiv.org/abs/2012.02516
Ho, J., Jain, A., & Abbeel, P. (2020). Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems, 33, 6840–6851.
Radford, A., Kim, J. W., Hallacy, C., Ramesh, A., Goh, G., Agarwal, S., Sastry, G., Askell, A., Mishkin, P., Clark, J., Krueger, G., & Sutskever, I. (2021). Learning transferable visual models from natural language supervision. Proceedings of the 38th International Conference on Machine Learning, 139, 8748–8763.
Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-resolution image synthesis with latent diffusion models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 10684–10695.https://doi.org/10.1109/CVPR52688.2022.01042
Stability AI. (2022, agosto 22). Stable Diffusion public release. https://stability.ai/news/stable-diffusion-public-release