DeepSeek: Arquitectura, Evolución, Aplicaciones y Retos de una Familia Eficiente de Modelos de Lenguaje
Origen y Propósito de DeepSeek
DeepSeek es una empresa china especializada en investigación y desarrollo de inteligencia
artificial. Fue fundada en julio de 2023 por Liang Wenfeng y está respaldada por High-Flyer,
un fondo cuantitativo que utilizaba modelos de aprendizaje automático para apoyar decisiones
de inversión (Forbes, 2026; Reuters, 2025). High-Flyer anunció previamente la creación de un
laboratorio enfocado en inteligencia artificial general, el cual posteriormente se convirtió en la
compañía independiente DeepSeek.
La meta general de DeepSeek es contribuir al desarrollo de inteligencia artificial general o AGI
(Artificial General Intelligence). Este concepto se refiere a sistemas capaces de resolver problemas
en múltiples dominios cognitivos, en lugar de limitarse a una sola tarea, como reconocimiento de imágenes o clasificación de documentos. Aunque la AGI aún no existe como tecnología demostrada, funciona como una orientación de investigación para empresas que desarrollan LLMs cada vez más capaces (Venture Atlas, 2026).
La estrategia de DeepSeek puede comprenderse a partir de tres objetivos principales:
- Desarrollar modelos competitivos en razonamiento, programación y comprensión de lenguaje.
- Reducir el costo de entrenamiento e inferencia mediante innovaciones arquitectónicas.
- Hacer disponibles ciertos modelos o pesos para investigación y uso técnico, aunque esto no
implica necesariamente que todo el ciclo de entrenamiento sea completamente abierto.
Es importante diferenciar los términos código abierto, pesos abiertos y modelo accesible por
API. Un modelo de código abierto debería publicar, idealmente, código, pesos, datos de entrena-
miento y metodología completa. Un modelo de pesos abiertos permite descargar parámetros ya entrenados, pero no necesariamente conocer todos los datos ni reproducir el proceso de entrena-
miento. Una API, por su parte, permite usar el modelo remoto sin acceder a sus parámetros in-
ternos. DeepSeek combina estas modalidades según el producto o versión del modelo (DeepSeek, s. f.; Wikipedia contributors, 2026).
Fundamentos Técnicos de DeepSeek
Los modelos de DeepSeek se basan en la arquitectura Transformer, una estructura de redes
neuronales que procesa secuencias de texto y calcula qué partes del contexto son más relevantes
para producir la siguiente palabra o token. Un token es una unidad de texto que puede ser una
palabra, una parte de una palabra, un signo de puntuación o un símbolo de programación.
La principal diferencia de DeepSeek frente a un modelo Transformer convencional se encuentra
en sus métodos para reducir la cantidad de cómputo y memoria requeridos. Sus dos innovaciones
más conocidas son Mixture of Experts y Multi-head Latent Attention (DeepSeek, 2024).
Mixture of Experts
Mixture of Experts o MoE puede traducirse como “mezcla de expertos”. Es una arquitectura en
la que el modelo contiene múltiples subredes neuronales denominadas expertos. En lugar de utilizar
todos los parámetros del modelo para cada token, un componente llamado router selecciona solo
algunos expertos relevantes para procesar la entrada (DeepSeek, 2024).
Una analogía útil consiste en imaginar una universidad con cientos de especialistas. Si una
persona pregunta sobre álgebra, no es necesario convocar a todos los profesores; bastaría con
activar a los expertos en matemáticas, razonamiento y explicación pedagógica. En un modelo MoE
sucede algo similar: el router determina qué expertos contribuyen a responder cada fragmento de
texto.
DeepSeek-V3 es conocido por emplear una arquitectura MoE con aproximadamente 671 mil
millones de parámetros totales, aunque solo una parte de ellos se activa durante la generación
de cada token (DeepSeek, 2024). Esta separación entre parámetros totales y parámetros activos
permite aumentar la capacidad del modelo sin multiplicar proporcionalmente el costo de cada
respuesta.
Las principales ventajas de MoE son las siguientes:
- Permite construir modelos muy grandes con costos de inferencia más bajos que los de modelos densos equivalentes.
- Favorece la especialización funcional de distintas subredes.
- Hace más eficiente el procesamiento de tareas diversas, como texto, código, matemáticas y razonamiento.
- Puede reducir el costo de operar aplicaciones con millones de consultas.
No obstante, MoE también presenta dificultades. El entrenamiento es más complejo porque
el router debe aprender a seleccionar expertos de forma equilibrada. Si algunos expertos se usan
demasiado y otros casi nunca, la eficiencia disminuye. Además, la distribución de expertos en
varias GPU puede añadir latencia y complejidad operativa.
Multi-head Latent Attention
La segunda innovación importante es Multi-head Latent Attention o MLA. Para comprenderla,
es necesario considerar que un LLM necesita conservar información sobre el texto previo de una
conversación o documento. Esta memoria temporal se guarda habitualmente en un mecanismo
denominado caché de claves y valores, o Key-Value Cache.
En modelos convencionales, el caché KV puede consumir mucha memoria de GPU cuando el
contexto crece. Por ejemplo, analizar un libro completo, un repositorio de software o una conversación extensa exige recordar una gran cantidad de tokens. Esto incrementa el costo y puede limitar
la longitud máxima de contexto que puede procesar el modelo (DeepSeek, 2024).
MLA busca resolver este problema mediante compresión. En vez de almacenar todas las claves
y valores completos para cada cabeza de atención, DeepSeek utiliza representaciones latentes más
compactas y reconstruye parte de la información necesaria durante la inferencia. El objetivo es
disminuir el uso de memoria sin perder de manera significativa la capacidad del modelo para
comprender el contexto.
En términos sencillos, MLA funciona como un sistema de apuntes inteligentes. En lugar de
guardar una transcripción completa de una conversación, conserva una versión comprimida de
la información relevante, que puede utilizar para reconstruir relaciones entre las palabras cuando
necesita responder.
Las ventajas de MLA incluyen:
- Menor consumo de memoria VRAM.
- Capacidad de trabajar con contextos de texto más extensos.
- Menores costos de operación en aplicaciones de larga conversación.
- Mayor viabilidad para analizar documentos amplios o bases de código.
La limitación principal es que la compresión implica una arquitectura más compleja. El equilibrio entre compresión, velocidad y precisión depende de la implementación y de la tarea solicitada.
Modelos de Razonamiento
DeepSeek-R1 pertenece a la categoría de modelos de razonamiento. A diferencia de un modelo general que suele responder directamente, un modelo de razonamiento está entrenado para
dedicar más procesamiento a problemas que requieren varios pasos, tales como demostraciones
matemáticas, programación compleja, planificación o lógica formal.
DeepSeek-R1 fue presentado en enero de 2025 junto con versiones destiladas más pequeñas.
El modelo se hizo conocido por su enfoque de aprendizaje por refuerzo aplicado al razonamiento,
lo que permite que genere procesos intermedios de análisis antes de formular una respuesta final
(Venture Atlas, 2026).
En una tarea matemática, por ejemplo, un modelo general podría proporcionar solo un resultado. Un modelo de razonamiento puede identificar el tipo de problema, definir las variables, realizar
cálculos intermedios, comprobar restricciones y finalmente entregar una solución explicada. Esto
resulta especialmente valioso en contextos educativos y de programación, aunque no elimina la
necesidad de verificar la respuesta.
Los modelos de razonamiento son recomendables para:
- Problemas de matemáticas, física, estadística y lógica.
- Diseño y revisión de algoritmos.
- Depuración de errores de software difíciles.
- Planificación de proyectos con múltiples restricciones.
- Análisis estructurado de alternativas.
Su principal desventaja es que suelen tardar más en responder y consumir más tokens que un
modelo rápido orientado a tareas simples.
Evolución de los Modelos DeepSeek
La evolución reciente de DeepSeek puede entenderse a través de sus modelos V3, R1 y sus
sucesores. La Tabla 1 resume los modelos más relevantes asociados con la empresa.
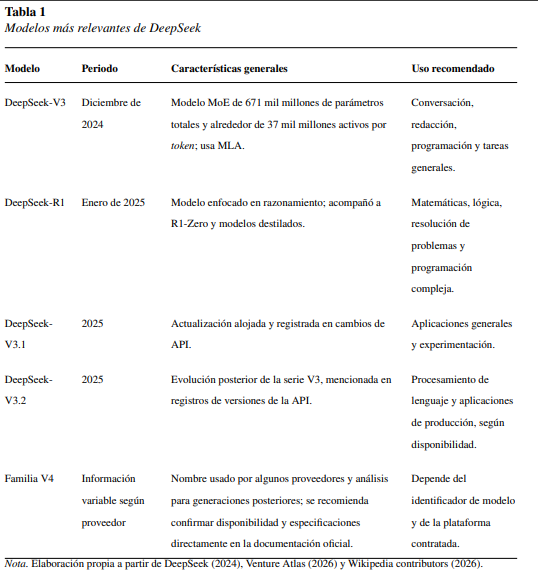
Una observación importante es que los nombres y disponibilidades de modelos pueden variar
entre la plataforma oficial, proveedores de infraestructura y publicaciones de terceros. Por esa
razón, un proyecto académico o empresarial no debe basarse únicamente en tablas comparativas
externas; debe comprobar el nombre exacto del modelo, la fecha, la licencia, el contexto disponible, los precios y las condiciones de uso en la documentación oficial antes de desplegarlo (DeepSeek,
s. f.). La plataforma de DeepSeek ofrece una API compatible con el formato de OpenAI para
algunos de sus modelos.
Productos y Usos Recomendados
DeepSeek ofrece productos orientados a usuarios finales y desarrolladores. Su servicio de chat
permite interactuar mediante una interfaz conversacional, mientras que su plataforma API permite
integrar capacidades de IA en aplicaciones externas (DeepSeek, s. f.).
La elección de un modelo debe depender del tipo de tarea, del presupuesto, del nivel de precisión requerido, de las restricciones de privacidad y del tiempo de respuesta aceptable. La Tabla 2
presenta recomendaciones según el tipo de tarea.
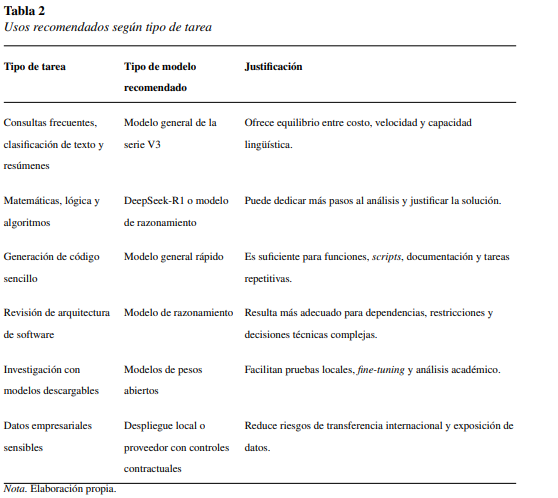
No existe un único modelo “mejor” para todas las situaciones. Una empresa que procesa millones de mensajes breves puede priorizar costo y velocidad; un investigador que resuelve ecuaciones
complejas puede priorizar razonamiento; y una institución con datos confidenciales puede priorizar
despliegue local y cumplimiento normativo.
Ventajas de DeepSeek
DeepSeek se diferencia por una combinación de eficiencia arquitectónica, orientación técnica
y acceso relativamente amplio a algunos modelos.
Eficiencia Computacional
La combinación de MoE y MLA permite que DeepSeek gestione la capacidad de modelos grandes sin utilizar todos sus parámetros en cada token. Esto reduce la cantidad de cómputo necesaria
para atender solicitudes y puede disminuir costos de infraestructura (DeepSeek, 2024)
Rendimiento en Razonamiento y Programación
La familia R1 ha despertado interés por su desempeño en problemas que requieren pasos intermedios, especialmente en matemáticas, lógica y generación de código. La disponibilidad de
versiones destiladas también facilita el uso de capacidades de razonamiento en modelos más pequeños (Venture Atlas, 2026).
Disponibilidad de Pesos Abiertos
Algunos modelos de DeepSeek publican pesos bajo licencias que permiten investigación, experimentación y, dependiendo de la licencia, usos comerciales (DeepSeek, 2024). Esto permite que
universidades, desarrolladores y organizaciones prueben modelos de manera local sin depender
exclusivamente de una API remota.
API Compatible con Herramientas Existentes
DeepSeek proporciona una API compatible con el estilo de OpenAI, lo cual reduce el esfuerzo de migración para desarrolladores que ya usan formatos de mensajes, funciones y bibliotecas
comunes del ecosistema de LLMs (DeepSeek, s. f.).
Competencia y Reducción de Costos
La irrupción de DeepSeek ha contribuido a aumentar la competencia en el mercado de IA
generativa. Desde una perspectiva económica, más proveedores y arquitecturas eficientes pueden
favorecer a usuarios finales, instituciones educativas y pequeñas empresas al reducir barreras de
costo (Venture Atlas, 2026).
Limitaciones y Riesgos
A pesar de sus ventajas, DeepSeek no debe utilizarse como una fuente infalible ni como sustituto de juicio humano especializado. Los riesgos principales se agrupan en limitaciones técnicas,
privacidad, transparencia y consideraciones geopolíticas.
Errores y Alucinaciones
Como cualquier LLM, DeepSeek puede producir información falsa con apariencia convincente.
Este fenómeno se conoce como alucinación. Puede manifestarse como citas inexistentes, datos
numéricos incorrectos, explicaciones científicas incompletas o código que parece correcto pero
contiene errores.
Por esta razón, los resultados deben verificarse especialmente en contextos médicos, legales,
financieros, científicos o académicos. Un buen uso de DeepSeek consiste en emplearlo para generar
borradores, hipótesis, esquemas o explicaciones preliminares, y luego contrastar la información
con fuentes confiables.
Privacidad de Datos
La política y los términos de la plataforma indican que DeepSeek recopila y procesa información personal conforme a su política de privacidad (DeepSeek, s. f.). Antes de enviar información a
una API externa, es necesario evaluar qué datos se transmitirán, dónde se almacenarán, por cuánto
tiempo y qué normativa aplica al caso.
No se recomienda introducir sin autorización:
- Datos personales identificables.
- Historias clínicas.
- Contraseñas, claves API o secretos empresariales.
- Información financiera privada.
- Código propietario crítico.
- Documentos legales o contratos confidenciales
Las organizaciones sometidas a normativas como el Reglamento General de Protección de
Datos de la Unión Europea deben revisar contratos, localización de datos, mecanismos de transferencia y controles de seguridad antes de adoptar una plataforma de IA.
Transparencia y Reproducibilidad
La publicación de pesos no equivale necesariamente a transparencia total. Si no se conocen los
datos de entrenamiento, los filtros aplicados, los procedimientos de alineación y todas las fases del
entrenamiento, resulta difícil reproducir completamente el modelo o auditar sus sesgos (Wikipedia
contributors, 2026).
Esto no significa que el modelo carezca de valor científico, pero sí limita el nivel de certeza que
puede atribuirse a sus resultados y dificulta evaluar con precisión riesgos de sesgo o contaminación
de datos.
Sesgo y Restricciones de Contenido
Los modelos de lenguaje reflejan patrones de sus datos de entrenamiento y las decisiones de
seguridad de sus desarrolladores. Como resultado, pueden reproducir sesgos culturales, lingüísticos, políticos o sociales. Además, pueden negarse a responder determinadas preguntas o presentar
respuestas parciales sobre asuntos políticamente sensibles.
Los usuarios deben evaluar la adecuación del modelo para contextos educativos, periodísticos, gubernamentales o de investigación social. La triangulación con fuentes independientes y la
revisión humana son esenciales.
Riesgo de Dependencia
Una organización que construye todos sus productos sobre una sola API puede quedar expuesta
a cambios de precio, disponibilidad, políticas, límites de uso o restricciones geopolíticas. Es recomendable diseñar aplicaciones con una capa de abstracción que permita cambiar entre proveedores
o modelos si es necesario.
Aplicaciones Prácticas
Educación
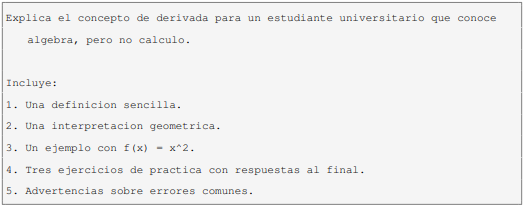
DeepSeek puede utilizarse como apoyo para tutoría personalizada. Un estudiante puede pedir
una explicación gradual de una derivada, un concepto de física o un algoritmo de programación.
Los modelos de razonamiento son especialmente adecuados cuando se solicita que expliquen los
pasos, identifiquen supuestos y verifiquen resultados.
También puede ayudar a docentes a crear ejercicios, rúbricas, preguntas de práctica y guías
de estudio. Sin embargo, la evaluación final del aprendizaje debe mantenerse bajo supervisión
humana, porque un LLM puede cometer errores o simplificar en exceso conceptos importantes.
Ejemplo de prompt educativo:
Programación
DeepSeek puede asistir en generación de funciones, revisión de código, documentación, pruebas automatizadas, depuración y refactorización. Para tareas rutinarias, un modelo general puede
ser suficiente; para algoritmos complejos o errores difíciles de identificar, es preferible utilizar un
modelo de razonamiento.
Ejemplo de prompt para programación:

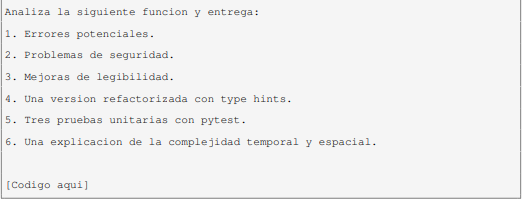
La respuesta debe probarse en un entorno real. La IA puede sugerir soluciones inválidas, bibliotecas inexistentes o configuraciones inseguras.
Investigación Académica
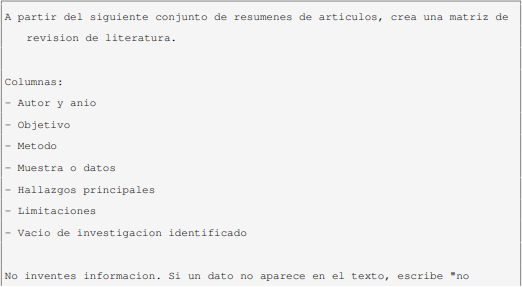
DeepSeek puede servir para resumir artículos proporcionados por el usuario, organizar matrices
de literatura, convertir preguntas de investigación en hipótesis, apoyar análisis de datos y mejorar
redacción académica. No debe utilizarse para inventar referencias ni para reemplazar la revisión
directa de fuentes.
Ejemplo de prompt para investigación:

Empresas
Las empresas pueden utilizar DeepSeek para clasificar correos, resumir reuniones, extraer información de documentos, redactar respuestas de soporte, generar reportes y automatizar tareas
administrativas. El beneficio principal es la posibilidad de reducir tiempos de trabajo repetitivo.
No obstante, las empresas deben implementar controles: anonimización de datos, validación
humana, auditorías de prompts, políticas de acceso, registro de decisiones y evaluación periódica
del desempeño del modelo.
Desarrollo de Software
En desarrollo de software, DeepSeek puede integrarse en entornos de desarrollo integrados,
sistemas de revisión de pull requests, herramientas de documentación y agentes de prueba. Por
ejemplo, un agente puede analizar un repositorio, identificar funciones sin pruebas, generar borradores de tests y ejecutar validaciones en un entorno aislado.
La automatización no debe permitir que el modelo despliegue cambios directamente en producción sin revisiones, pruebas y aprobaciones humanas.
Diferencias Frente a Otros Sistemas de IA Generativa
DeepSeek comparte características con sistemas como GPT, Claude y Gemini: todos son LLMs
capaces de procesar instrucciones, generar texto y asistir con código. Sin embargo, difiere en su
estrategia tecnológica y de disponibilidad (Tabla 3).
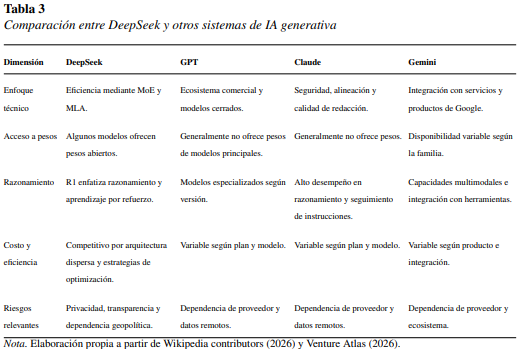
La diferencia más importante no es que DeepSeek sea necesariamente superior en todos los
escenarios, sino que propone una ruta alternativa: priorizar eficiencia de cómputo y disponibilidad
de ciertos pesos para competir con modelos cerrados de mayor costo. Esta característica lo hace
atractivo para tareas de programación, razonamiento y procesamiento masivo de texto.
La API de DeepSeek
Una API (Application Programming Interface) permite que un programa envíe instrucciones a
un modelo de IA y reciba una respuesta estructurada. La API de DeepSeek es compatible con el
formato de llamadas utilizado por muchas aplicaciones basadas en OpenAI, lo que puede facilitar
su adopción por parte de desarrolladores (DeepSeek, s. f.).
La API puede utilizarse para:
- Crear chatbots de atención al cliente.
- Generar resúmenes automáticos de documentos.
- Clasificar solicitudes o correos electrónicos.
- Asistir en programación dentro de una aplicación.
- Generar contenido estructurado en JSON.
- Construir asistentes educativos.
- Integrar modelos de razonamiento en flujos de trabajo.
Ejemplo conceptual en Python:
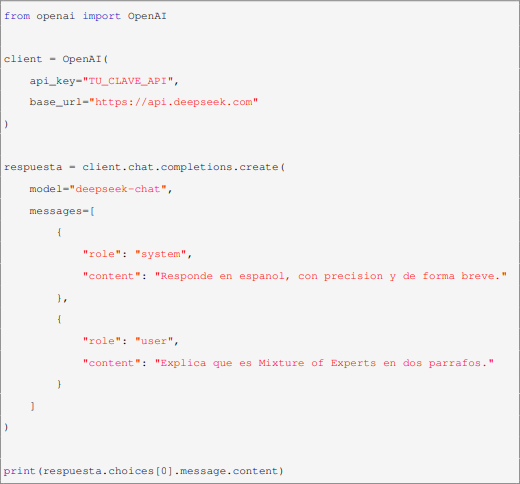
Este código es ilustrativo. Antes de implementarlo se debe confirmar en la documentación oficial el identificador vigente del modelo, los límites de uso, los costos, las medidas de seguridad y la
sintaxis actual de la API. La disponibilidad de una API compatible con OpenAI está documentada
en el repositorio de DeepSeek-V3 (DeepSeek, 2024).
Ejemplos de Prompts Eficaces
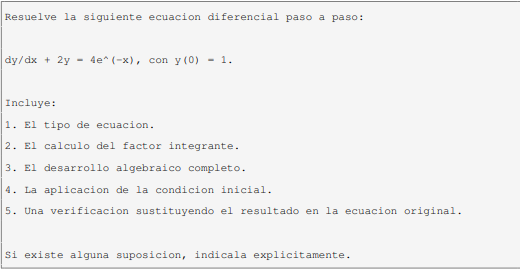
Los buenos prompts suelen incluir contexto, objetivo, formato esperado, restricciones y criterios de verificación. A continuación se presentan ejemplos aplicables a DeepSeek y a otros LLMs.
Prompt para Matemáticas
Prompt para Programación
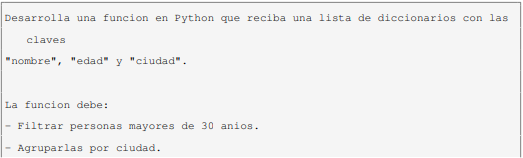
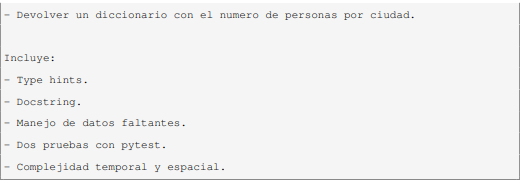
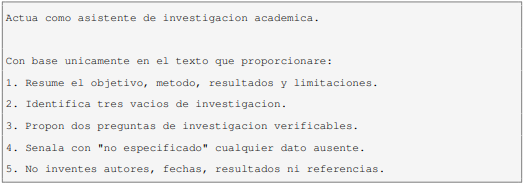
Prompt para Investigación
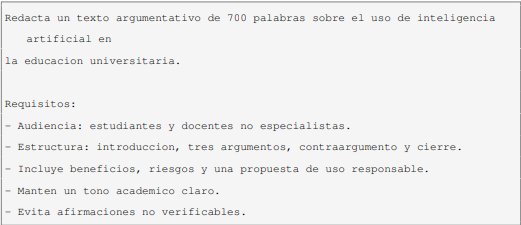
Prompt para Escritura
Se Determinó
DeepSeek constituye uno de los casos más relevantes en la evolución reciente de la inteligencia
artificial generativa. Su importancia se debe a que combina modelos de lenguaje de gran escala con
arquitecturas diseñadas para reducir costos de cómputo y memoria. La utilización de Mixture of
Experts permite activar solo una parte de los parámetros durante cada operación, mientras que
Multi-head Latent Attention reduce la memoria requerida para trabajar con contextos extensos
(DeepSeek, 2024).
La aparición de DeepSeek-V3 mostró la viabilidad de modelos MoE de gran tamaño; posteriormente, DeepSeek-R1 consolidó el interés por los modelos orientados al razonamiento. La
combinación de eficiencia, desempeño técnico y disponibilidad de algunos pesos abiertos crea
oportunidades para investigación, educación, programación y automatización empresarial (Venture Atlas, 2026).
No obstante, DeepSeek no debe considerarse una herramienta neutral, perfecta ni adecuada
para cualquier situación. Sus resultados pueden contener errores, alucinaciones o sesgos. Además,
el uso de servicios basados en API plantea preguntas sobre privacidad, cumplimiento normativo y
transferencia internacional de datos. Los términos de la plataforma reconocen la recopilación y el
procesamiento de información personal bajo su política de privacidad (DeepSeek, s. f.).
En consecuencia, la recomendación principal es utilizar DeepSeek como una herramienta de
apoyo, no como sustituto de la evaluación humana. Su aplicación responsable requiere verificar
resultados, no compartir datos confidenciales sin controles adecuados, probar el código generado y
mantener supervisión experta en ámbitos de alto riesgo. Bajo estas condiciones, DeepSeek puede
aportar valor significativo al acceso más amplio y eficiente a capacidades avanzadas de inteligencia
artificial.
Créditos
Autor: Ana Maria Avellaneda Gomez, Keny Santiago Lizarazo Rivera
Editor: Mag. Ingeniero Carlos Ivan Pinzon Romero
Código: UCIAT-7
Universidad: Universidad Central
fuentes
DeepSeek. (2024). DeepSeek-V3 [Repositorio de código]. GitHub. https://github.com/
deepseek-ai/DeepSeek-V3
DeepSeek. (s. f.). DeepSeek open platform terms of service. https://cdn.deepseek.com/
policies/en-US/deepseek-open-platform-terms-of-service.html
Forbes. (2026, 10 de marzo). Liang Wenfeng. https://www.forbes.com/profile/liang-wenfeng/
Reuters. (2025, 29 de enero). High-Flyer, the AI quant fund behind China’s DeepSeek. https://
www.reuters.com/technology/artificial-intelligence/high-flyer-ai-quant
Venture Atlas. (2026, 9 de septiembre). DeepSeek: Company profile, milestones & funding. https:
//www.ventureatlas.org/company/deepseek
Wikipedia contributors. (2026). DeepSeek. En Wikipedia. https://en.wikipedia.org/
wiki/DeepSeek