Redes Neuronales, la Tecnología que Enseñó a Pensar a las Máquinas
La Tecnología que Enseñó a Pensar a las Máquinas
Las redes neuronales artificiales (RNA) dejaron de ser un tema exclusivo de laboratorios de investigación para convertirse en una de las bases técnicas predominantes de muchas aplicaciones modernas de inteligencia artificial, especialmente en visión, lenguaje, audio y generación de contenido (LeCun et al., 2015). Aunque su nombre evoca directamente al cerebro humano, se trata de un modelo matemático que aprende a partir de datos, ajustando parámetros internos hasta lograr predicciones cada vez más precisas.
¿Qué es una Red Neuronal Artificial?
Una red neuronal artificial puede definirse como un modelo computacional conformado por capas de nodos interconectados o neuronas artificiales diseñado para identificar patrones no lineales en los datos (Google for Developers, s. f.-b). Cada uno de estos nodos recibe valores numéricos como entrada, los transforma mediante operaciones matemáticas y envía el resultado hacia las neuronas de la capa siguiente, en un flujo organizado por módulos o capas (PyTorch, 2026a). Dicha estructura se inspira, de manera simplificada, en la forma en que las neuronas biológicas intercambian señales entre sí mediante las sinapsis.
Sin embargo, conviene aclarar que las RNA no reproducen el funcionamiento real del cerebro: se trata de modelos computacionales organizados en capas que aprenden representaciones jerárquicas a partir de los datos, y que pueden entrenarse y ejecutarse en paralelo mediante hardware especializado, sin replicar los procesos cognitivos complejos que caracterizan a la mente humana (LeCun et al., 2015).
Anatomía de una Neurona Artificial: Pesos, Sesgos y Activación
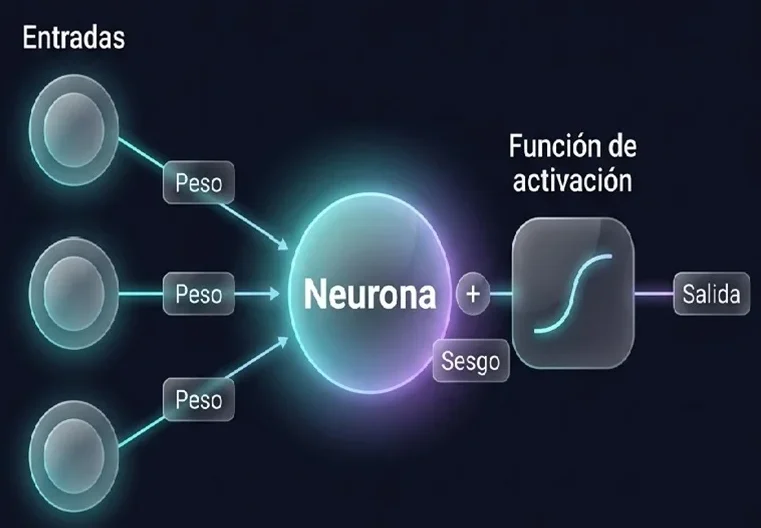
El funcionamiento de cada neurona artificial se apoya en cuatro elementos esenciales. En primer lugar están las entradas (x), que corresponden a los datos que recibe la neurona; luego los pesos (w), encargados de definir qué tanta importancia tiene cada entrada y que se ajustan durante el entrenamiento mediante el cálculo de la suma ponderada (Google for Developers, s. f.-a ); después el sesgo (b), un parámetro entrenable que desplaza el resultado para lograr un mejor ajuste del modelo, tal como se define en la construcción de capas de una red (PyTorch, 2026a); y finalmente la función de activación, que permite a la red aprender relaciones no lineales y determina cuánta información continúa hacia la siguiente capa (Google for Developers, s. f.-a). Entre las funciones más empleadas se encuentran la sigmoide, ReLU y softmax (TensorFlow, s. f.). De manera matemática, todo el proceso se resume en la expresión z=w1x1+w2x2+ . . . +wnxn+b, seguida de y=f(z), donde f representa la función de activación (Google for Developers, s. f.-a). Es importante destacar que, en una capa de clasificación, softmax se aplica normalmente al vector completo de salidas (logits) y no de manera independiente a cada neurona. Esta operación, repetida en miles o incluso millones de neuronas al mismo tiempo, constituye el fundamento de todo el aprendizaje profundo.
El Proceso de Entrenamiento
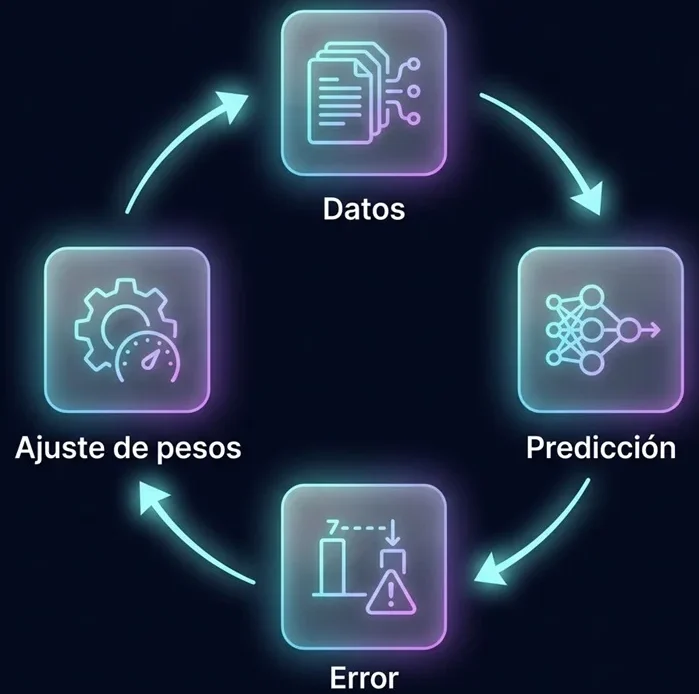
El entrenamiento es el mecanismo mediante el cual una red neuronal modifica sus pesos y sesgos con el fin de reducir al mínimo sus errores. Inicialmente los datos recorren la red capa por capa en lo que se conoce como propagación hacia adelante, un proceso mediante el cual se procesa un lote de datos para producir predicciones y calcular la pérdida (Google for Developers, s. f.-a). Dicha predicción se contrasta con el valor real por medio de una función de pérdida, que mide la distancia entre la salida del modelo y la respuesta correcta (PyTorch, 2023). Con base en ese error, el algoritmo de retropropagación (backpropagation) calcula los gradientes que determinan de qué forma cada peso contribuyó al fallo, apoyándose en la regla de la cadena del cálculo diferencial (Google for Developers, s. f.-c). Posteriormente, un optimizador como el descenso de gradiente o Adam actualiza los parámetros en la dirección que disminuye el error, cerrando el ciclo de pérdida, retropropagación y ajuste de parámetros (PyTorch, 2026b). Este proceso se repite de manera iterativa a lo largo de múltiples épocas; sin embargo, la generalización del modelo no debe darse por hecha simplemente porque el error de entrenamiento disminuye, sino que debe evaluarse con conjuntos de datos de validación y prueba, pudiendo emplearse técnicas como el early stopping para evitar el sobreajuste (Goodfellow et al., 2016).
Distintas Arquitecturas para Distintos Problemas
Es importante señalar que no todas las redes neuronales son iguales, pues existen arquitecturas pensadas para distintos tipos de datos. Las redes feedforward representan la variante más sencilla, ya que corresponden a modelos sin ciclos dirigidos entre unidades, en los que la información circula en una sola dirección (Goodfellow et al., 2016). Por su parte, las redes convolucionales (CNN) están especializadas en el tratamiento de imágenes y emplean filtros que aprovechan conexiones locales para detectar bordes, texturas y formas, un enfoque documentado desde los primeros trabajos de clasificación de imágenes con redes convolucionales profundas ejecutadas en GPU (Krizhevsky et al., 2012). Las redes recurrentes (RNN) trabajan con datos secuenciales como el texto, el audio o las series temporales, conservando una especie de memoria entre un paso y otro para tareas como la clasificación de secuencias (PyTorch, 2025). No obstante, presentan dificultades cuando las secuencias se vuelven demasiado largas. Las LSTM surgen precisamente para mitigar ese inconveniente, incorporando mecanismos de compuertas que deciden qué información se conserva y cuál se descarta (Hochreiter y Schmidhuber, 1997). Finalmente, los Transformers, presentados en 2017, prescinden de la recurrencia y las convoluciones para basarse únicamente en mecanismos de atención, procesando las secuencias de forma altamente paralelizable durante el entrenamiento (Vaswani et al., 2017). Los Transformers sustentan numerosas familias de modelos de lenguaje entre ellas BERT y GPT, otros sistemas comerciales también se basan total o parcialmente en arquitecturas de atención, aunque sus detalles de entrenamiento no siempre están publicados íntegramente.
Sectores Enteros que ya Dependen de Ellas
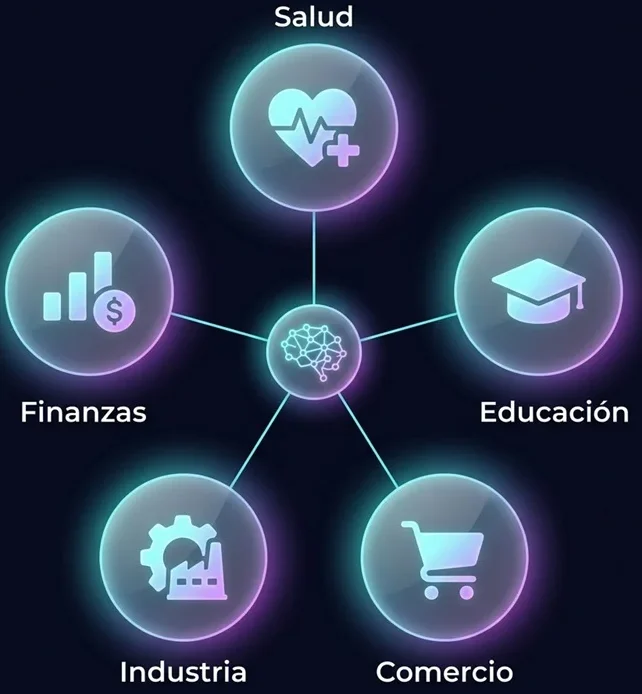
Las redes neuronales se utilizan en numerosos sectores, aunque su adopción depende de los datos disponibles, el costo computacional, la regulación y el nivel de criticidad de cada aplicación. En el sector de la salud, los avances del aprendizaje profundo en reconocimiento visual han impulsado su uso para apoyar la detección de patologías en radiografías y resonancias, aunque este tipo de aplicaciones clínicas requiere validación específica antes de su implementación (LeCun et al., 2015). En el sector financiero, diversas revisiones sistemáticas documentan el uso creciente de arquitecturas de aprendizaje profundo como redes convolucionales, LSTM y Transformers, para la detección de fraude en transacciones con tarjeta, reclamaciones de seguros y auditorías financieras (Chen et al., 2025). En la industria, la capacidad de reconocimiento visual mediante aprendizaje profundo se aplica al control de calidad automatizado (LeCun et al., 2015). En cuanto al consumo masivo, Netflix ha documentado públicamente el uso de RNA en su sistema de recomendaciones (Steck et al., 2021). Por otro lado, las RNA también sostienen buena parte de la ola actual de IA generativa, presente en la producción automática de texto, imágenes, voz y música.
Fortaleza de las Redes Neuronales
En definitiva, la principal ventaja o fortaleza de las redes neuronales es su alta capacidad para identificar patrones complejos que los algoritmos tradicionales no alcanzan a capturar, especialmente en visión artificial y procesamiento de lenguaje, gracias a su capacidad de extraer representaciones jerárquicas de los datos (LeCun et al., 2015). Asimismo, aprenden automáticamente qué características de los datos son fundamentales con distintos niveles de abstracción, sin necesidad de que un humano las defina de forma manual (LeCun et al., 2015). Estas redes también son escalables y capaces de procesar grandes volúmenes de información. Este principio se evidenció históricamente con el entrenamiento de una red convolucional profunda sobre un conjunto de datos de gran escala (Krizhevsky et al., 2012), y ha sido formalizado más recientemente mediante estudios que muestran que el rendimiento de las redes neuronales mejora de forma predecible al aumentar el tamaño del modelo, los datos de entrenamiento y el cómputo disponible (Kaplan et al., 2020), aunque esto no implica que toda arquitectura sea igualmente escalable. Además, son versátiles, ya que la misma arquitectura base puede adaptarse a tareas de clasificación, regresión o generación de contenido y con datos suficientes, una arquitectura adecuada y recursos de entrenamiento apropiados, pueden superar a métodos tradicionales en determinadas tareas, aunque no garantizan mejores resultados en todos los conjuntos de datos (LeCun et al., 2015).
Limitaciones
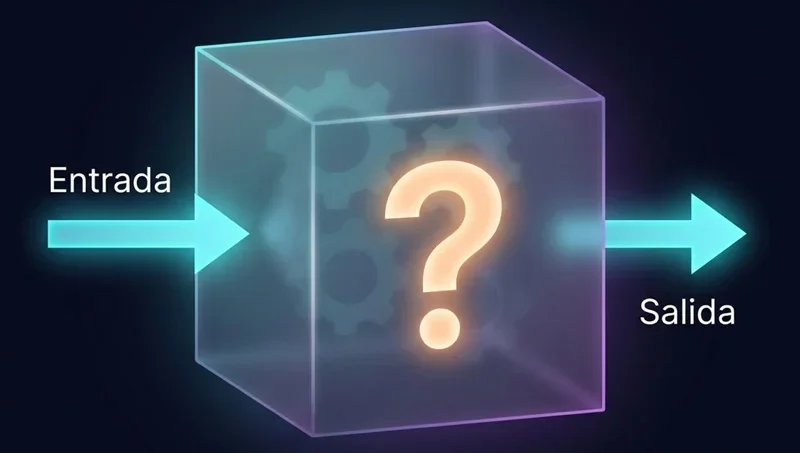
En las redes neuronales no todo son ventajas. Los escenarios supervisados suelen requerir grandes volúmenes de datos etiquetados, aunque técnicas como el aprendizaje autosupervisado y la transferencia de aprendizaje reducen esa dependencia (LeCun et al., 2015). Además, su entrenamiento demanda una capacidad computacional considerable, generalmente basada en GPUs (Krizhevsky et al., 2012). Uno de los problemas más debatidos es su naturaleza de caja negra, pues resulta difícil explicar por qué un modelo tomó una decisión específica, lo cual es delicado en ámbitos como la salud y la justicia (Tabassi, 2023). De igual manera, son propensas al sobreajuste u overfitting, memorizando datos de entrenamiento en lugar de generalizar (Goodfellow et al., 2016), y pueden reproducir sesgos presentes en los datos con los que fueron entrenadas (Tabassi, 2023).
Entrenamiento de Redes Neuronales a partir de Imágenes
Una de las formas más accesibles de comprender el funcionamiento de una red neuronal es entrenar un modelo propio sin necesidad de escribir código. Teachable Machine, desarrollada por Google, permite crear modelos de clasificación de imágenes mediante redes neuronales convolucionales de forma visual e intuitiva (Google, s. f.). El proceso consiste en definir un conjunto de clases o categorías, capturar ejemplos de cada una a través de la cámara web (o cargando imágenes propias), y dejar que el algoritmo ajuste automáticamente sus parámetros internos hasta reconocer los patrones visuales que distinguen a cada clase. Una vez entrenado, el modelo puede exportarse en formato TensorFlow.js para integrarse en una página web y ejecutarse en tiempo real directamente en el navegador, sin necesidad de un servidor especializado.
Reconocimiento de Lenguaje de Señas Mediante Teachable Machine
A modo de ejemplo práctico, se desarrolló un modelo capaz de reconocer en tiempo real señas del alfabeto en lenguaje de señas utilizando Teachable Machine, una herramienta gratuita basada en redes neuronales convolucionales (Google, s. f.). El proceso comenzó con la definición de las clases o categorías que el modelo debía aprender a distinguir, correspondientes a cada seña específica. Para cada una de estas clases se recolectó un conjunto de imágenes de entrenamiento, a través de la cámara web en distintos ángulos, con el fin de que el modelo aprendiera a reconocer el patrón visual característico de cada seña. Una vez recolectadas las imágenes de todas las clases, la herramienta entrenó automáticamente la red neuronal convolucional ajustando sus parámetros internos a partir de dicha información, sin que fuera necesario escribir código ni configurar manualmente la arquitectura del modelo. Finalmente, el modelo entrenado se probó en tiempo real directamente desde el navegador, clasificando la señal mostrada frente a la cámara y devolviendo un porcentaje de confianza para cada clase, lo que permitió evaluar de forma inmediata su precisión y ajustar el conjunto de imágenes en caso de ser necesario. El proceso completo de entrenamiento y su aplicación se muestra en el video tutorial que acompaña este artículo.
Videos de apoyo
Si quieres profundizar en lo que viste en este artículo, estos dos videos complementan la lectura:
Redes neuronales explicadas y entrenamiento con Teachable Machine
En este video se resume todo el contenido del artículo: qué son las redes neuronales, cómo aprenden y cómo entrenar un modelo con imágenes usando Teachable Machine, paso a paso.
Producto final: reconocimiento de lenguaje de señas en acción
Aquí se muestra completo el proyecto que creamos a partir del modelo entrenado en Teachable Machine, funcionando en tiempo real y reconociendo las señas A, B, C y “OK”.
Créditos
Autoras: Laura Nataly Murcia Fuentes y María Paula Méndez López
Editor: Mg. Carlos Iván Pinzón Romero
Código: UCIAT
Universidad: Universidad Central
Fuentes
Chen, Y., Zhao, C., Xu, Y., Nie, C., y Zhang, Y. (2025). Year-over-year developments in financial fraud detection via deep learning: A systematic literature review (arXiv:2502.00201). arXiv. https://arxiv.org/abs/2502.00201
Goodfellow, I., Bengio, Y., y Courville, A. (2016). Deep learning. MIT Press. https://www.deeplearningbook.org/
Google. (2026, 11 de septiembre). Gemini (versión 3.6 Flash) [Large language model].Gemini. https://gemini.google.com
Google. (s. f.). Teachable Machine. Teachable Machine https://teachablemachine.withgoogle.com/
Google for Developers. (s. f.-a). Machine learning glossary: ML fundamentals. Teachable Machine. https://developers.google.com/machine-learning/glossary/fundamentals
Google for Developers. (s. f.-b). Neural networks. Teachable Machine. https://developers.google.com/machine-learning/crash-course/neural-networks
Google for Developers. (s. f.-c). Neural networks: Training using backpropagation. Teachable Machine. https://developers.google.com/machine-learning/crash-course/neural-networks/backpropagation
Hochreiter, S., y Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735–1780. https://doi.org/10.1162/neco.1997.9.8.1735
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., y Amodei, D. (2020). Scaling laws for neural language models (arXiv:2001.08361). arXiv. https://doi.org/10.48550/arXiv.2001.08361
Krizhevsky, A., Sutskever, I., y Hinton, G. E. (2012). ImageNet classification with deep convolutional neural networks. Advances in Neural Information Processing Systems, 25, 1097–1105. https://proceedings.neurips.cc/paper_files/paper/2012/file/c399862d3b9d6b76c8436e924a68c45b-Paper.pdf
LeCun, Y., Bengio, Y., y Hinton, G. (2015). Deep learning. Nature, 521(7553), 436–444. https://doi.org/10.1038/nature14539
Murcia Fuentes, L. N., y Méndez López, M. P. (2026, 30 de septiembre). Redes Neuronales- IA [Video]. YouTube. https://youtu.be/vm1oJwIPDnc
Murcia Fuentes, L. N., y Méndez López, M. P. (2026, 30 de septiembre). Tutorial: Reconocimiento del alfabeto en lenguaje de señas con RNA [Video]. YouTube. https://youtu.be/Py53CrsYars
Murcia Fuentes, L. N., y Méndez López, M. P. (2026a, 2 de octubre). Anatomía de una neurona artificial [Imagen]. Niixer. https://niixer.com/wp-content/uploads/2026/10/2-edited.webp
Murcia Fuentes, L. N., y Méndez López, M. P. (2026b, 2 de octubre). Ciclo de entrenamiento de una red neuronal [Imagen]. Niixer. https://niixer.com/wp-content/uploads/2026/10/3-edited.webp
Murcia Fuentes, L. N., y Méndez López, M. P. (2026c, 2 de octubre). El problema de la caja negra en la interpretabilidad de las redes neuronales [Imagen]. Niixer. https://niixer.com/wp-content/uploads/2026/10/5-edited.webp
Murcia Fuentes, L. N., y Méndez López, M. P. (2026d, 2 de octubre). Red neuronal artificial [Imagen]. Niixer. https://niixer.com/wp-content/uploads/2026/10/portada-en-1280×720-1.webp
Murcia Fuentes, L. N., y Méndez López, M. P. (2026e, 2 de octubre). Sectores de aplicación de las redes neuronales artificiales [Imagen]. Niixer. https://niixer.com/wp-content/uploads/2026/10/4-edited.webp
PyTorch. (2023, 31 de mayo). Deep learning with PyTorch: A 60-minute blitz. PyTorch Tutorials. https://docs.pytorch.org/tutorials/beginner/deep_learning_60min_blitz.html
PyTorch. (2025, 11 de noviembre). NLP from scratch: Classifying names with a character-level RNN. PyTorch Tutorials. https://docs.pytorch.org/tutorials/intermediate/char_rnn_classification_tutorial.html
PyTorch. (2026a, 25 de agosto). Build the neural network. PyTorch Tutorials. https://docs.pytorch.org/tutorials/beginner/basics/buildmodel_tutorial.html
PyTorch. (2026b, 11 de mayo). Neural networks. PyTorch Tutorials. https://docs.pytorch.org/tutorials/beginner/blitz/neural_networks_tutorial.html
Steck, H., Baltrunas, L., Elahi, E., Liang, D., Raimond, Y., y Basilico, J. (2021). Deep learning for recommender systems: A Netflix case study. AI Magazine, 42(3), 7–18. https://doi.org/10.1609/aaai.12013
Tabassi, E. (2023). Artificial intelligence risk management framework (AI RMF 1.0). National Institute of Standards and Technology. https://doi.org/10.6028/NIST.AI.100-1
TensorFlow. (s. f.). Keras activations. TensorFlow. https://www.tensorflow.org/api_docs/python/tf/keras/activations
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., y Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998–6008. https://proceedings.neurips.cc/paper_files/paper/2017/file/3f5ee243547dee91fbd053c1c4a845aa-Paper.pdf