Fine-Tuning de IA: Guía Completa con Ejemplo Práctico
Introducción
El fine-tuning de IA, o ajuste fino de modelos de inteligencia artificial, es una de las técnicas más importantes del aprendizaje automático actual. Permite tomar un modelo preentrenado y adaptarlo a una tarea específica con un conjunto de datos pequeño y especializado.
A diferencia del entrenamiento desde cero, no exige una inversión masiva en tiempo, datos y cómputo. El fine-tuning de IA aprovecha el conocimiento que el modelo ya capturó en sus capas profundas. Así se acelera la convergencia y mejora el rendimiento en dominios particulares.
Este artículo es una guía completa e independiente sobre el tema. Puedes leerlo por sí solo o complementarlo con los tutoriales en video que lo acompañan. Todos los recursos cubren la misma información en formatos distintos.
1. ¿Qué es el Fine-Tuning? Definición y fundamentos
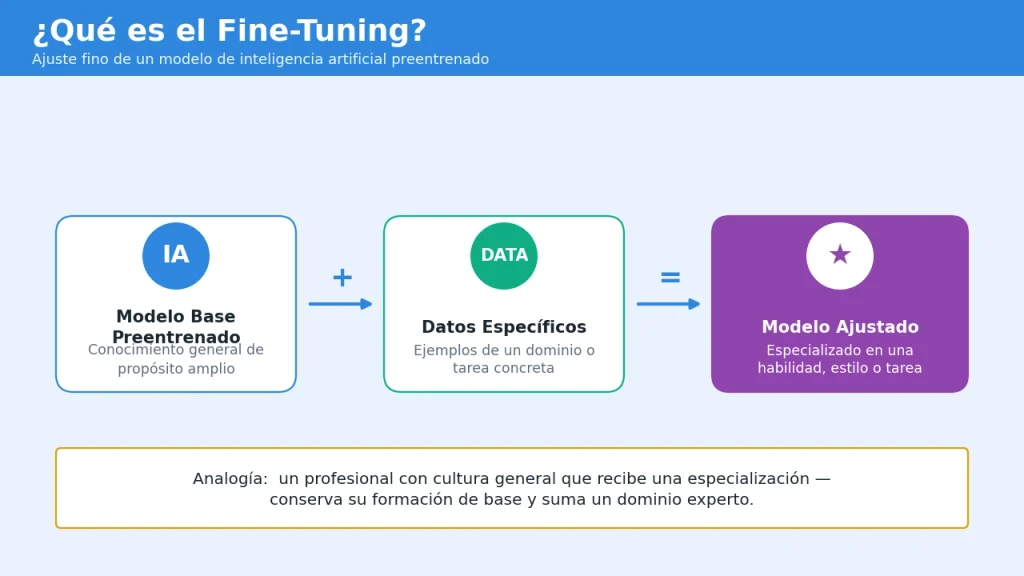
El fine-tuning es un proceso de aprendizaje por transferencia. Consiste en ajustar los parámetros de un modelo preentrenado con datos específicos de un dominio. En esencia, se hacen entrenamientos adicionales sobre pesos que ya fueron optimizados para reconocer patrones generales en datos masivos.
Esta técnica es efectiva porque el modelo base ya posee representaciones matemáticas sofisticadas de conceptos lingüísticos, visuales o de otro tipo. Esas representaciones se refinan con muchos menos datos de los que exigiría un entrenamiento desde cero (OpenAI, s. f.-c).
Una analogía útil es la de un profesional con sólida cultura general que recibe una especialización. No pierde su formación de base, sino que la complementa con un dominio experto en un área concreta.
En términos prácticos, el fine-tuning de IA no busca solo introducir conocimiento nuevo. Su meta es adaptar el comportamiento, el estilo o el formato de respuesta del modelo a un objetivo específico.
2. ¿Cómo Funciona el Fine-Tuning? Del Modelo Base al Modelo Especializado
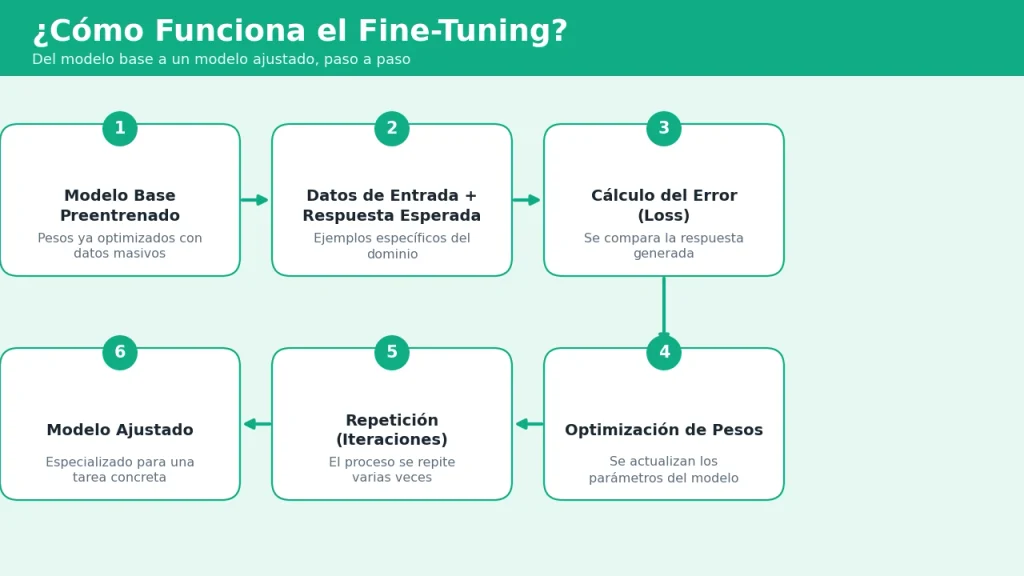
Comprender el mecanismo interno ayuda a distinguir el fine-tuning de otras estrategias de personalización. El proceso parte de un modelo base cuyos pesos ya codifican patrones generales del lenguaje o de la tarea original.
A este modelo se le presentan pares de datos: una entrada y la respuesta esperada, propias del dominio que se quiere reforzar. Con cada ejemplo, el sistema calcula el error o loss, es decir, la diferencia entre lo generado y lo esperado. Ese error alimenta un proceso de optimización que actualiza gradualmente los pesos.
El ciclo se repite durante numerosas iteraciones hasta que el desempeño converge. El resultado es un modelo ajustado, capaz de resolver una tarea concreta con mayor precisión que el modelo original.
Llevar esto a la práctica exige un proceso ordenado:
- Definir un objetivo medible.
- Recolectar y limpiar los datos.
- Dividirlos en conjuntos de entrenamiento, validación y prueba.
- Formatearlos y tokenizarlos.
- Configurar y ejecutar el entrenamiento.
- Evaluar, desplegar y monitorear el modelo en producción
3. Tipos de Fine-Tuning y Herramientas para Implementarlo
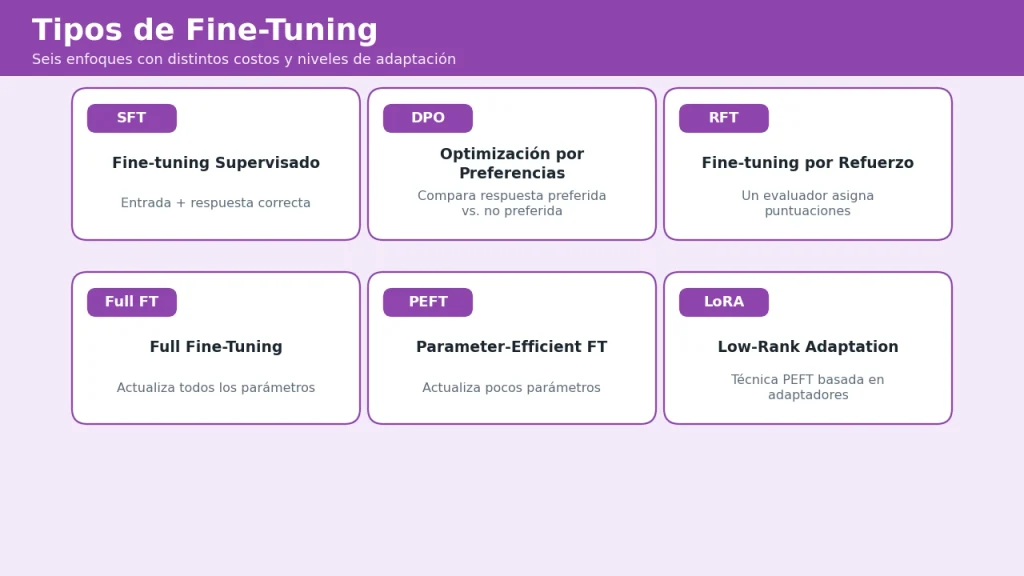
Existen múltiples enfoques de fine-tuning. Cada uno equilibra de forma distinta el rendimiento y los recursos necesarios.
Según el método de entrenamiento
- SFT (fine-tuning supervisado): entrena al modelo con pares de entrada y respuesta correcta. Es útil cuando la tarea tiene una salida esperada clara (OpenAI, s. f.-c).
- DPO (optimización por preferencias): compara una respuesta preferida con una no preferida. Mejora la calidad, el tono o la seguridad.
- RFT (fine-tuning por refuerzo): introduce un evaluador que asigna puntuaciones. Es útil en tareas verificables (OpenAI, s. f.-a).
Según el alcance del ajuste
- Full fine-tuning: actualiza todos los parámetros. Ofrece la mayor capacidad de adaptación, pero con un costo computacional elevado.
- PEFT (parameter-efficient fine-tuning): actualiza solo un subconjunto reducido de parámetros. Así reduce drásticamente el costo.
- LoRA (Low-Rank Adaptation): es una técnica de PEFT basada en adaptadores. Se convirtió en estándar para ajustar modelos grandes con hardware accesible (Hu et al., 2021).
Para llevarlo a la práctica, el ecosistema de herramientas ha madurado. Hugging Face Transformers ofrece API simplificadas para el ajuste fino (Hugging Face, s. f.). PyTorch facilita el entrenamiento a bajo nivel. Las plataformas en la nube permiten delegar la infraestructura. Completan los recursos el acceso a GPU y los datasets en formato JSONL.
4. La Calidad de los Datos y los Parámetros de Entrenamiento
La calidad de los datos es, con frecuencia, el factor más determinante del éxito de un proyecto de fine-tuning de IA. Pesa incluso más que la cantidad de ejemplos.
Un buen dataset debe cumplir estas condiciones:
- Contener ejemplos correctos y consistentes.
- Cubrir casos frecuentes, complejos y límite.
- Mantener un formato similar al del uso real.
- Estar libre de duplicados, errores e información confidencial o sin permiso.
- Conservar un conjunto de prueba separado.
Los datos de mala calidad producen modelos de mala calidad, sin importar cuán sofisticada sea la arquitectura.
Los parámetros de entrenamiento determinan cómo aprende el modelo:
- Epochs: cuántas veces recorre el dataset.
- Batch size: cuántos ejemplos se procesan por actualización.
- Learning rate: el tamaño de cada ajuste de pesos.
- Longitud máxima de tokens: el tamaño permitido de cada entrada.
Técnicas como el gradient accumulation y los checkpoints permiten entrenar modelos grandes con recursos limitados. Mientras tanto, la función de pérdida (loss) sigue siendo la señal principal para medir el avance del entrenamiento.
5. Caso de Aplicación: Detección de Comentarios Tóxicos con Fine-Tuning
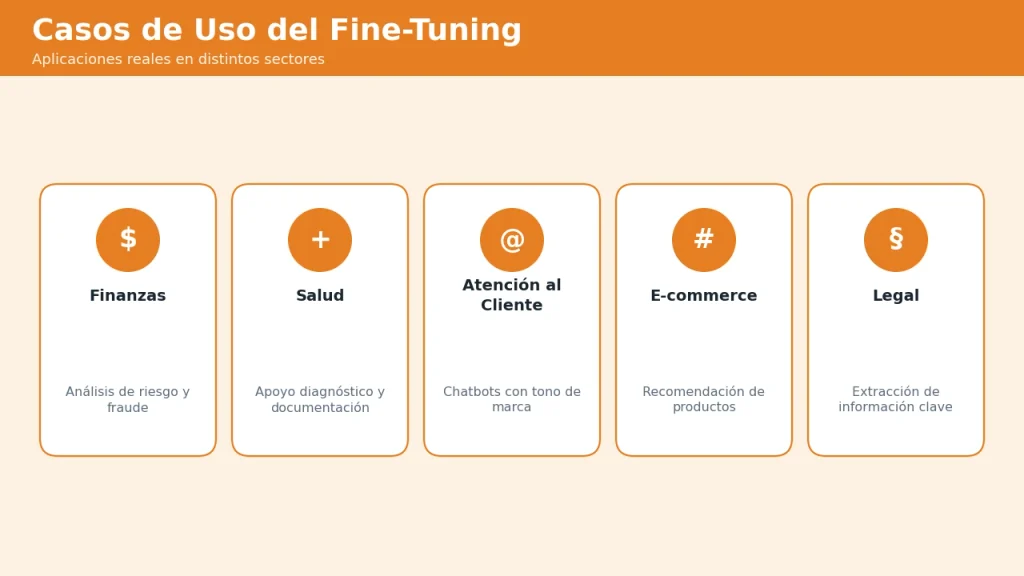
Más allá de la teoría, el fine-tuning de IA tiene aplicación directa en tareas de clasificación de texto. Sus usos van desde el análisis de riesgo financiero hasta la generación de respuestas de soporte con el tono de una marca.
En este trabajo se implementó un caso real: un modelo ajustado para detectar comentarios tóxicos. Es decir, un sistema que clasifica automáticamente un comentario como tóxico o no tóxico según su contenido. Esta tarea es representativa del procesamiento de lenguaje natural (NLP) aplicado. Sirve para moderar contenido en redes sociales, foros y plataformas de atención al cliente.
La implementación se realizó en Google Colab, un entorno gratuito con acceso a GPU. Permite instalar librerías como Hugging Face Transformers sin configuración local (Hugging Face, s. f.). El proceso siguió los pasos generales descritos antes:
- Se preparó un conjunto de datos etiquetado con comentarios tóxicos y no tóxicos.
- Se tokenizaron los textos y se cargó un modelo preentrenado de clasificación de secuencias.
- Se configuraron los parámetros de entrenamiento: número de épocas, tamaño de lote y tasa de aprendizaje.
- Se ejecutó el ajuste fino sobre el modelo base.
- Se evaluó el desempeño con datos de prueba no vistos durante el entrenamiento.
El resultado es un modelo capaz de clasificar comentarios nuevos en tiempo real. Ante la entrada «Excelente trabajo, muchas gracias.», el modelo responde NO TÓXICO. Un comentario con lenguaje ofensivo se clasifica como TÓXICO.
Este caso ilustra cómo el fine-tuning de IA adapta un modelo genérico de lenguaje a una tarea de clasificación binaria específica. Su utilidad para la moderación automática de contenido es clara.
6. Evaluación del Desempeño, Riesgos y Limitaciones
La evaluación requiere métricas claras que evidencien una mejora real en la tarea. Lo ideal es comparar siempre el modelo base con el modelo ajustado sobre datos no vistos durante el entrenamiento.
En clasificación, las métricas más usadas son la exactitud, la precisión, el recall y el F1-score. En generación estructurada se evalúa además la validez del formato. Muchas veces se complementa con evaluación humana mediante una rúbrica, pruebas de robustez y pruebas A/B.
Una señal de alerta constante es el sobreajuste u overfitting. Ocurre cuando el modelo memoriza los datos de entrenamiento en lugar de aprender patrones generalizables.
El fine-tuning enfrenta además otros riesgos:
- Olvido catastrófico: el modelo pierde capacidades generales durante la especialización.
- Sesgos: los del dataset pueden trasladarse al modelo ajustado.
- Alucinaciones y fuga de información sensible.
- Costos de infraestructura y licencias de los modelos y los datos utilizados.
Por último, el fine-tuning no garantiza conocimiento actualizado más allá de lo que contienen los datos de ajuste (OpenAI, s. f.-b).
7. Fine-Tuning frente a Prompting y RAG: Comparación y Perspectivas Futuras
Antes de elegir una estrategia conviene comparar el fine-tuning con sus alternativas:
- Prompting (in-context learning): es preferible para instrucciones simples o pocos ejemplos. No modifica el modelo y da resultados inmediatos sin entrenamiento.
- RAG (Retrieval-Augmented Generation): resulta más adecuado cuando se requiere información reciente o documentos internos. Recupera contexto externo antes de generar la respuesta, sin alterar los parámetros (Lewis et al., 2020).
- Fine-tuning: es la opción más apropiada cuando se busca un comportamiento, un formato o un estilo consistentes en el tiempo. Modifica los parámetros internos del modelo.
La elección depende de la precisión requerida, el presupuesto computacional, el tiempo disponible y la complejidad de la tarea. En la práctica, muchos proyectos combinan las tres técnicas.
El futuro del fine-tuning de IA apunta hacia la automatización y la democratización. Técnicas como LoRA seguirán evolucionando para ajustar modelos cada vez más grandes con hardware estándar. Además, la convergencia con el edge computing abrirá oportunidades para hacer fine-tuning en dispositivos locales. Eso mejoraría la privacidad y la latencia.
Conclusión
El fine-tuning de IA es un hito crucial en la democratización y la adopción práctica de sistemas de inteligencia artificial avanzados. Adapta modelos preentrenados masivos a contextos especializados con una inversión mucho menor que el entrenamiento desde cero. Eso ha transformado la ecuación económica de los proyectos de machine learning.
Como se expuso en este artículo, el éxito de un proceso de fine-tuning depende de cuatro factores centrales:
- Un objetivo claro y medible.
- Un dataset de calidad.
- Una evaluación rigurosa.
- Una comparación honesta frente a alternativas como el prompting y el RAG.
Persisten desafíos técnicos como el olvido catastrófico o el sobreajuste. Aun así, el ritmo de innovación en herramientas, técnicas eficientes y metodologías de evaluación sugiere un panorama cada vez más accesible y poderoso.
Para equipos de ingeniería de software, científicos de datos y emprendedores, dominar el fine-tuning de IA no es opcional. Es esencial para competir en la era de la inteligencia artificial generativa.
Créditos
Autor: Nicolas David Cruz Fandiño y Julian Andres Castellanos Pinzon
Editor: Mg. Ing. Carlos Ivan Pinzon Romero
Código: UC IAT-9
Universidad : Universidad Central
Fuentes
Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., & Chen, W. (2021). LoRA: Low-rank adaptation of large language models. arXiv. https://doi.org/10.48550/arXiv.2106.09685
Hugging Face. (s. f.). Fine-tuning. Transformers documentation. Recuperado el 18 de septiembre de 2026, de https://huggingface.co/docs/transformers/en/training
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W.-t., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. arXiv. https://doi.org/10.48550/arXiv.2005.11401
OpenAI. (s. f.-a). Fine-tuning techniques: Choosing between SFT, DPO, and RFT. OpenAI Cookbook. Recuperado el 18 de septiembre de 2026, de https://developers.openai.com/cookbook/examples/fine_tuning_direct_preference_optimization_guide
OpenAI. (s. f.-b). Model optimization. OpenAI API documentation. Recuperado el 18 de septiembre de 2026, de https://developers.openai.com/api/docs/guides/model-optimization
OpenAI. (s. f.-c). Supervised fine-tuning. OpenAI API documentation. Recuperado el 18 de septiembre de 2026, de https://developers.openai.com/api/docs/guides/supervised-fine-tuning
Cruz Fandiño, N. D. (2026, 21 de septiembre). VideoTutorial FineTuning - Nicolas Cruz y Julian Castellanos [Video]. YouTube. https://youtu.be/k2PHwWHXkQA
Cruz Fandiño, N. D., & Castellanos Pinzón, J. A. (2026, 21 de septiembre). Implementación herramientas Perplexity y GitMind - Nicolas Cruz Julian Castellanos [Video]. YouTube. https://youtu.be/XUn9V8zPawY