Fine-Tuning de Modelos de Inteligencia Artificial: Optimización Personalizada para Aplicaciones Específicas
Introducción
El fine-tuning o ajuste fino de modelos de inteligencia artificial representa uno de los avances más significativos en el campo del aprendizaje automático contemporáneo. Esta técnica permite tomar un modelo preentrenado, desarrollado con millones de ejemplos y recursos computacionales considerables, y adaptarlo para tareas específicas con conjuntos de datos más pequeños y especializados. A diferencia del entrenamiento desde cero, que requiere una inversión masiva en tiempo, datos y cómputo, el fine-tuning aprovecha el conocimiento ya capturado en las capas profundas del modelo para acelerar la convergencia y mejorar el rendimiento en dominios particulares. Este artículo funciona como una guía completa e independiente sobre el tema: puede leerse por sí sola o complementarse con los tutoriales en video que acompañan este material, ya que todos los recursos cubren la misma información desde formatos distintos
1. ¿Qué es el Fine-Tuning? Definición y Fundamentos Conceptuales
El fine-tuning es un proceso de aprendizaje por transferencia en el cual se ajustan los parámetros de un modelo preentrenado mediante nuevos datos específicos de un dominio particular. En esencia, se trata de realizar entrenamientos adicionales sobre pesos que ya han sido optimizados para reconocer patrones generales en datos masivos. Esta técnica es particularmente efectiva porque el modelo base ya posee representaciones matemáticas sofisticadas de conceptos lingüísticos, visuales o de otro tipo, que pueden ser refinadas con muchos menos datos de los que requeriría un entrenamiento desde cero (OpenAI, s. f.-c). Una analogía útil es la de un profesional con una sólida cultura general que recibe una especialización: no pierde su formación de base, sino que la complementa con un dominio experto en un área concreta. En términos prácticos, el fine-tuning no busca únicamente introducir conocimiento nuevo, sino adaptar el comportamiento, el estilo o el formato de respuesta del modelo a un objetivo específico.
2. ¿Cómo Funciona el Fine-Tuning? Del Modelo Base al Modelo Especializado
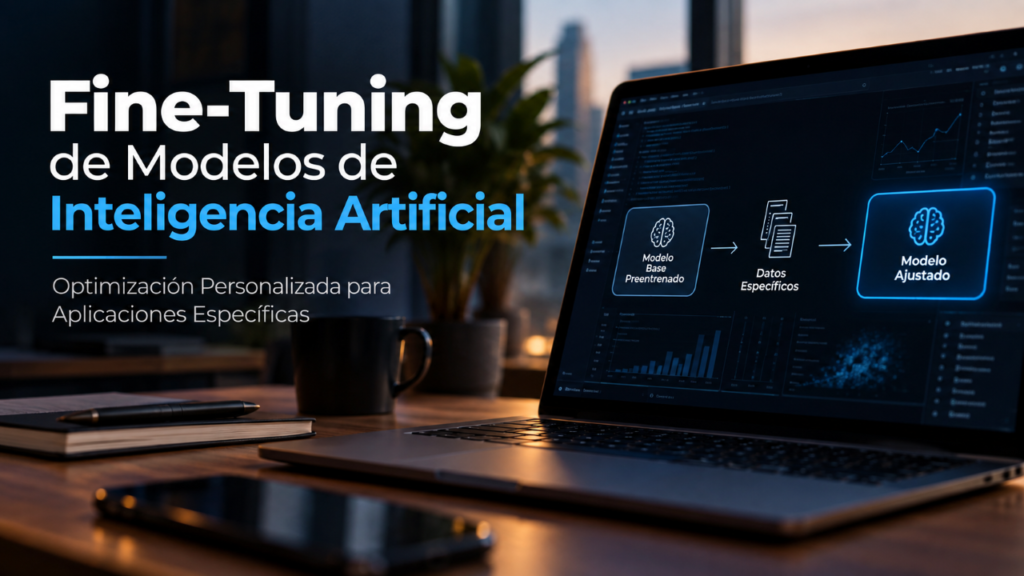
Comprender el mecanismo interno del fine-tuning ayuda a distinguirlo de otras estrategias de personalización de IA. El proceso parte de un modelo base cuyos pesos ya codifican patrones generales del lenguaje o de la tarea original. A este modelo se le presentan pares de datos de entrada y la respuesta esperada, propios del dominio que se quiere reforzar. Con cada ejemplo, el sistema calcula el error o loss —la diferencia entre lo generado y lo esperado— y lo utiliza para ejecutar un proceso de optimización que actualiza gradualmente los pesos. El ciclo se repite durante numerosas iteraciones hasta que el desempeño converge en un modelo ajustado, capaz de resolver una tarea concreta con mayor precisión que el modelo original. Llevar esto a la práctica exige un proceso de implementación ordenado: definir un objetivo medible, recolectar y limpiar los datos, dividirlos en conjuntos de entrenamiento, validación y prueba, formatearlos y tokenizarlos, configurar y ejecutar el entrenamiento, y finalmente evaluar, desplegar y monitorear el modelo en producción.
3. Tipos de Fine-Tuning y Herramientas para Implementarlo
Existen múltiples enfoques para implementar fine-tuning, cada uno con compensaciones distintas entre rendimiento y recursos requeridos. El fine-tuning supervisado (SFT) entrena al modelo con pares de entrada y respuesta correcta, útil cuando la tarea tiene una salida esperada clara (OpenAI, s. f.-c). La optimización por preferencias (DPO) compara una respuesta preferida frente a una no preferida, mejorando calidad, tono o seguridad, mientras que el fine-tuning por refuerzo (RFT) introduce un evaluador que asigna puntuaciones, útil en tareas verificables (OpenAI, s. f.-a). En cuanto al alcance del ajuste, el full fine-tuning actualiza todos los parámetros y ofrece la mayor capacidad de adaptación, a un costo computacional elevado; el parameter-efficient fine-tuning (PEFT) actualiza solo un subconjunto reducido de parámetros, reduciendo drásticamente el costo. Dentro de PEFT destaca LoRA (Low-Rank Adaptation), técnica basada en adaptadores convertida en estándar para ajustar modelos grandes con hardware accesible (Hu et al., 2021). Para llevarlo a la práctica, el ecosistema de herramientas ha madurado: Hugging Face Transformers ofrece API simplificadas para el ajuste fino (Hugging Face, s. f.), PyTorch facilita el entrenamiento a bajo nivel, las plataformas en la nube permiten delegar la infraestructura, y el acceso a GPUs junto con datasets en formato JSONL completa los recursos necesarios.
4. La Calidad de los Datos y los Parámetros de Entrenamiento
La calidad de los datos es, con frecuencia, el factor más determinante del éxito de un proyecto de fine-tuning, por encima incluso de la cantidad de ejemplos. Un buen dataset debe contener ejemplos correctos y consistentes, cubrir casos frecuentes, complejos y límite, y mantener un formato similar al del uso real. Es indispensable eliminar duplicados y errores, evitar información confidencial o sin permiso, y conservar un conjunto de prueba separado: datos de mala calidad producen modelos de mala calidad, sin importar cuán sofisticada sea la arquitectura. Los parámetros de entrenamiento determinan cómo aprende el modelo: los epochs indican cuántas veces recorre el dataset; el batch size define cuántos ejemplos se procesan por actualización; el learning rate controla el tamaño de cada ajuste de pesos; y la longitud máxima de tokens limita el tamaño de cada entrada. Técnicas como el gradient accumulation y los checkpoints permiten entrenar modelos grandes con recursos limitados, mientras la función de pérdida (loss) sigue siendo la señal principal para medir el avance del entrenamiento.
5. Caso de Aplicación: Detección de Comentarios Tóxicos con Fine-Tuning
Más allá de la teoría, el fine-tuning encuentra aplicación directa en tareas concretas de clasificación de texto, con usos que van desde el análisis de riesgo financiero hasta la generación de respuestas de soporte con el tono de una marca. En el desarrollo de este trabajo se implementó un caso real de este tipo: un modelo ajustado para detectar comentarios tóxicos, es decir, para clasificar automáticamente un comentario como tóxico o no tóxico según su contenido. Esta tarea es representativa del procesamiento de lenguaje natural (NLP) aplicado, con utilidad directa en la moderación de contenido en redes sociales, foros y plataformas de atención al cliente.
La implementación se realizó en Google Colab, un entorno gratuito que ofrece acceso a GPU y facilita instalar librerías como Hugging Face Transformers sin configuración local (Hugging Face, s. f.). El proceso siguió los pasos generales descritos en la sección anterior: primero se preparó un conjunto de datos etiquetado con comentarios marcados como tóxico o no tóxico; luego se tokenizaron los textos y se cargó un modelo preentrenado de clasificación de secuencias; después se configuraron los parámetros de entrenamiento (número de épocas, tamaño de lote y tasa de aprendizaje) y se ejecutó el ajuste fino sobre el modelo base; finalmente se evaluó el desempeño con datos de prueba no vistos durante el entrenamiento. El resultado es un modelo capaz de clasificar comentarios nuevos en tiempo real: ante la entrada «Excelente trabajo, muchas gracias.», el modelo responde NO TÓXICO, mientras que un comentario con lenguaje ofensivo se clasifica como TÓXICO. Este caso ilustra de forma concreta cómo el fine-tuning adapta un modelo genérico de lenguaje a una tarea de clasificación binaria específica, con una utilidad clara para la moderación automática de contenido.
6. Evaluación del Desempeño, Riesgos y Limitaciones
La evaluación del fine-tuning requiere establecer métricas claras que evidencien una mejora real en el rendimiento de la tarea, comparando siempre el modelo base frente al modelo ajustado sobre datos no vistos durante el entrenamiento. Entre las métricas más utilizadas en clasificación se encuentran la exactitud, la precisión, el recall y el F1-score; en generación estructurada se evalúa además la validez del formato, y en muchos casos se complementa con evaluación humana mediante una rúbrica, pruebas de robustez y pruebas A/B. Una señal de alerta constante es el sobreajuste u overfitting, fenómeno en el cual el modelo memoriza los datos de entrenamiento en lugar de aprender patrones generalizables. A pesar de sus ventajas, el fine-tuning enfrenta otros riesgos: el olvido catastrófico ocurre cuando el modelo pierde capacidades generales durante la especialización; los sesgos del dataset pueden trasladarse al modelo ajustado; persiste la posibilidad de alucinaciones y de fuga de información sensible; y deben considerarse los costos de infraestructura y las licencias de los modelos y los datos utilizados. El fine-tuning tampoco garantiza que el modelo cuente con conocimiento actualizado más allá de lo que contienen los datos de ajuste (OpenAI, s. f.-b).
7. Fine-Tuning frente a Prompting y RAG: Comparación y Perspectivas Futuras
Al momento de abordar una tarea de IA específica, existen alternativas al fine-tuning que conviene comparar antes de elegir una estrategia. El prompting o in-context learning es preferible para instrucciones simples o pocos ejemplos, ya que no modifica el modelo y ofrece resultados inmediatos sin entrenamiento. El RAG (Retrieval-Augmented Generation) resulta más adecuado cuando se requiere información reciente o el uso de documentos internos, pues recupera contexto externo antes de generar la respuesta, sin alterar los parámetros del modelo (Lewis et al., 2020). El fine-tuning, en cambio, es la opción más apropiada cuando se busca un comportamiento, un formato o un estilo consistentes en el tiempo, porque modifica los parámetros internos del modelo. La elección depende de la precisión requerida, el presupuesto computacional, el tiempo disponible y la complejidad de la tarea; en la práctica, muchos proyectos combinan las tres técnicas. El futuro del fine-tuning apunta hacia la automatización y la democratización: técnicas como LoRA seguirán evolucionando para ajustar modelos cada vez más grandes con hardware estándar, y la convergencia con el edge computing abrirá oportunidades para hacer fine-tuning en dispositivos locales, mejorando la privacidad y la latencia.
Conclusión
El fine-tuning de modelos de inteligencia artificial representa un hito crucial en la democratización y la adopción práctica de sistemas de IA avanzados. Su capacidad de adaptar modelos preentrenados masivos a contextos especializados, con una inversión reducida frente al entrenamiento desde cero, ha transformado la ecuación económica de los proyectos de machine learning. Como se ha expuesto a lo largo de este artículo, el éxito de un proceso de fine-tuning depende de cuatro factores centrales: un objetivo claro y medible, un dataset de calidad, una evaluación rigurosa y una comparación honesta frente a alternativas como el prompting y el RAG. Aunque persisten desafíos técnicos como el olvido catastrófico o el sobreajuste, el ritmo de innovación en herramientas, técnicas eficientes y metodologías de evaluación sugiere un panorama cada vez más accesible y poderoso. Para equipos de ingeniería de software, científicos de datos y emprendedores, comprender y dominar el fine-tuning no es opcional, sino esencial para competir en una era de inteligencia artificial generativa.
Créditos
Autor: Nicolas David Cruz Fandiño y Julian Andres Castellanos Pinzon
Editor: Mg. Ing. Carlos Ivan Pinzon Romero
Código: UC IAT-9
Universidad : Universidad Central
Fuentes
Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., & Chen, W. (2021). LoRA: Low-rank adaptation of large language models. arXiv. https://doi.org/10.48550/arXiv.2106.09685
Hugging Face. (s. f.). Fine-tuning. Transformers documentation. Recuperado el 18 de septiembre de 2026, de https://huggingface.co/docs/transformers/en/training
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W.-t., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. arXiv. https://doi.org/10.48550/arXiv.2005.11401
OpenAI. (s. f.-a). Fine-tuning techniques: Choosing between SFT, DPO, and RFT. OpenAI Cookbook. Recuperado el 18 de septiembre de 2026, de https://developers.openai.com/cookbook/examples/fine_tuning_direct_preference_optimization_guide
OpenAI. (s. f.-b). Model optimization. OpenAI API documentation. Recuperado el 18 de septiembre de 2026, de https://developers.openai.com/api/docs/guides/model-optimization
OpenAI. (s. f.-c). Supervised fine-tuning. OpenAI API documentation. Recuperado el 18 de septiembre de 2026, de https://developers.openai.com/api/docs/guides/supervised-fine-tuning