La automatización del modelado 3D mediante IA generativa: caso Meshy AI
Contexto y evolución de la IA generativa aplicada al espacio tridimensional: del 2D
al 3D
La generación tridimensional automatizada no emergió de un paradigma propio, sino como una extensión inferencial del éxito de los modelos de difusión bidimensionales. El punto de inflexión metodológico se sitúa en DreamFusion, donde se demostró que un modelo de difusión texto-imagen preentrenado sobre miles de millones de pares imagen-texto puede operar como prior para optimizar un campo de radiancia neuronal (NeRF) inicializado aleatoriamente, mediante una pérdida de destilación de densidad de probabilidad, sin requerir datos de entrenamiento 3D etiquetados (Poole, Jain, Barron y Mildenhall, 2022). Esta estrategia conocida como Score Distillation Sampling (SDS) resolvió el cuello de botella estructural del campo: la inexistencia de corpus 3D comparables en escala a LAION.
El costo de dicha elegancia fue computacional. La optimización per-prompt exigía minutos u horas por activo, lo que resultaba incompatible con flujos de producción industrial. La segunda generación de métodos abandonó la optimización iterativa en favor de la inferencia feed-forward: LRM introdujo una arquitectura basada en Transformers con 500 millones de parámetros aprendibles capaz de predecir un NeRF a partir de una única imagen en aproximadamente cinco segundos, entrenada de extremo a extremo sobre cerca de un millón de objetos procedentes de renderizados sintéticos de Objaverse y capturas reales de MVImgNet (Hong et al., 2023). TripoSR consolidó esa línea reduciendo la latencia a menos de 0,5 segundos por malla, sobre la misma base arquitectónica de LRM y bajo licencia MIT (Tochilkin et al., 2024).
Figura 1
Activo tridimensional de alta densidad geométrica obtenido por inferencia generativa
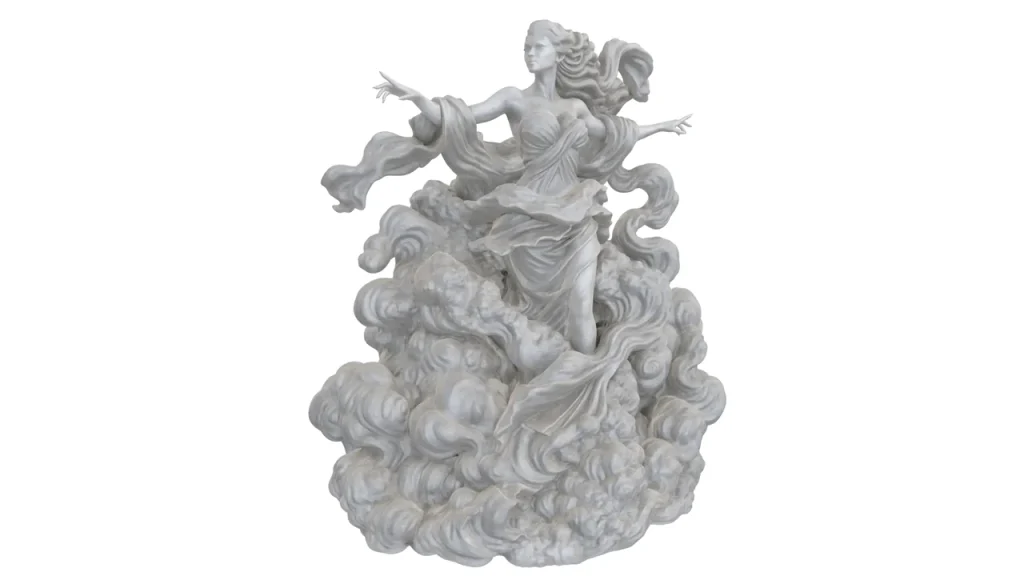
Nota. El nivel de detalle en pliegues, cabello y volutas ilustra la capacidad de síntesis de la tercera generación de modelos, en la que la forma se resuelve mediante transformers de difusión antes que por optimización per-prompt. De Meshy AI: Free AI 3D model generator, por Meshy, 2026f (https://www.meshy.ai). Copyright 2026 por Meshy
Paralelamente, la representación subyacente se diversificó. El 3D Gaussian Splatting desplazó parcialmente al NeRF al permitir renderizado de campos de radiancia en tiempo real con calidad de estado del arte (Kerbl, Kopanas, Leimkühler y Drettakis, 2023), mientras que la disponibilidad de Objaverse-XL más de diez millones de objetos 3D, doce veces mayor que Objaverse 1.0 habilitó el entrenamiento de modelos fundacionales 3D a escala (Deitke et al., 2023). La tercera generación, ejemplificada por Hunyuan3D 2.0 y su arquitectura de transformer de difusión basada en flujo (Hunyuan3D-DiT) acoplada a un modelo de síntesis de texturas (Hunyuan3D-Paint), formaliza la separación funcional entre generación de forma y generación de apariencia (Tencent Hunyuan3D Team, 2025). Es en este tercer estrato tecnológico donde debe situarse Meshy AI.
¿Qué es Meshy AI? Fundamentos técnicos, arquitectura de red y algoritmos subyacentes
Meshy AI es una plataforma comercial de modelado 3D asistido por IA que transforma descripciones textuales, imágenes 2D y prompts conversacionales en activos tridimensionales preparados para producción, cubriendo el ciclo completo de generación, posprocesamiento y exportación (Meshy, 2026a). Su espacio de trabajo web se organiza en seis módulos Image, 3D Model, 3D Printing, Animate, Scene y Video complementados por un agente conversacional (Meshy 3D Agent) que guía al usuario desde la idea hasta el modelo terminado.
Figura 2
Identidad visual de Meshy AI, plataforma objeto del presente análisis
Nota. La plataforma organiza su espacio de trabajo en seis módulos —Image, 3D Model, 3D Printing, Animate, Scene y Video— coordinados por un agente conversacional. De Meshy AI: Free AI 3D model generator, por Meshy, 2026f (https://www.meshy.ai). Copyright 2026 por Meshy.
La documentación oficial expone una taxonomía de modelos generativos versionados antes que una descripción de su arquitectura interna: Meshy 6 (2025), orientado a alta calidad y estabilidad estructural; Meshy 7 (2026), presentado como modelo fundacional de Image-to-3D centrado en la alineación entre imagen de entrada y resultado en términos de proporción general, distribución espacial y detalle de superficie; y la familia Smart Topology (Meshy T1/T2), optimizada para desarrollo de videojuegos y renderizado en tiempo real, con tiempos de generación del orden de segundos (Meshy, 2026a, 2026b).
Es metodológicamente relevante señalar una limitación de transparencia: Meshy no publica número de parámetros, composición del dataset, procedimiento de entrenamiento ni arquitectura de codificador-decodificador. Por tanto, cualquier atribución arquitectónica precisa debe formularse como inferencia y no como hecho documentado. La evidencia disponible latencias inferiores al minuto, entradas mono y multivista, y separación explícita entre etapa de malla y etapa de textura es consistente con un diseño de tipo feed-forward transformer con difusión latente sobre representación implícita, seguido de extracción de superficie y un modelo de texturizado condicionado por geometría, es decir, la misma familia metodológica descrita por Hong et al. (2023) y el Tencent Hunyuan3D Team (2025). Un indicio indirecto de la competitividad del modelo es su incorporación como motor seleccionable dentro de Spline, junto a Hunyuan3D y Trellis 2, con la caracterización de producir resultados que requieren poca limpieza posterior (Spline, 2026).
Análisis del pipeline Text-to-3D: del lenguaje natural al modelado poligonal
El pipeline Text-to-3D de Meshy opera actualmente sobre Meshy 6, con un costo declarado de 20 créditos por generación completa incluyendo etapas de malla y textura y una latencia típica cercana a un minuto (Meshy, 2026b). El procedimiento documentado es secuencial: selección de modelo, redacción del prompt, elección de calidad de salida (Standard o Smart Topology), generación, inspección en visor 3D y posprocesamiento o exportación.
Figura 3
Activo generado a partir de un prompt de alta especificidad material y estilística
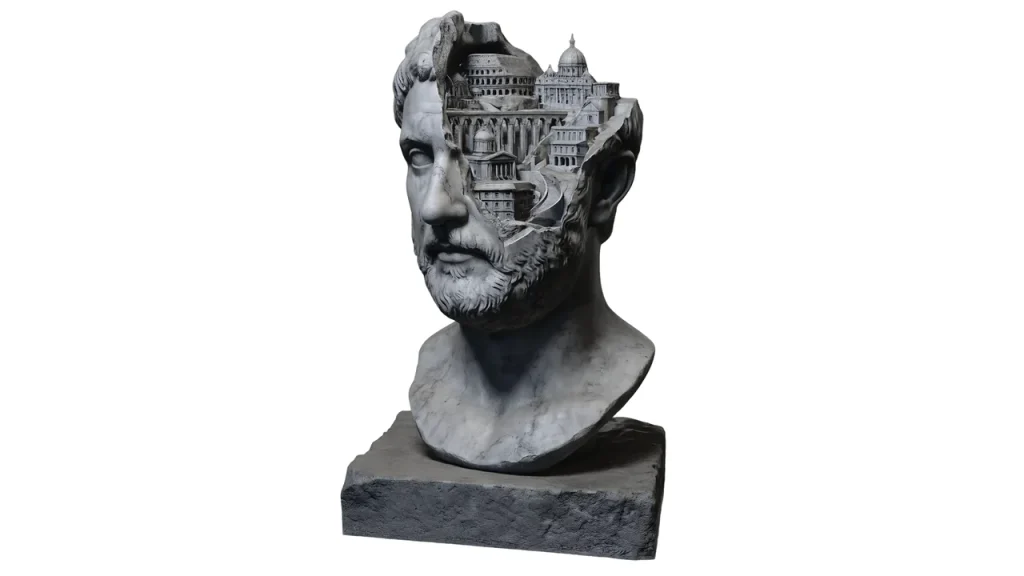
Nota. El resultado muestra las cuatro dimensiones del prompt operando simultáneamente: identidad del objeto (busto clásico), especificación material (mármol veteado), estilo artístico (surrealismo arquitectónico) y escala. La densidad de detalle en la columnata interior se sitúa en el rango de las 25.000 caras reportado por la documentación para prompts de alta especificidad material (Meshy, 2026b). De Meshy AI: Free AI 3D model generator, por Meshy, 2026f (https://www.meshy.ai). Copyright 2026 por Meshy.
La ingeniería de prompts se formaliza en cuatro dimensiones semánticas: identidad del objeto, especificación material, estilo artístico y escala métrica. La documentación reporta que un prompt de alta especificidad material produce mallas con detalle geométrico fino y texturas PBR metálicas del orden de 25.000 caras (Meshy, 2026b). Este dato es analíticamente significativo porque revela el rango de densidad poligonal en el que la plataforma se sitúa: suficiente para props de tiempo real, pero por encima de presupuestos móviles estrictos sin decimación previa.
Desde el punto de vista del control, el pipeline textual exhibe la limitación intrínseca del paradigma texto-a-forma: el lenguaje natural es un canal de baja densidad informativa para especificar geometría métrica. El estilo declarado condiciona además la calidad topológica la documentación reconoce que descriptores realistas incrementan el detalle mientras que estilos “stylized/cartoon” producen topología más limpia, y admite explícitamente que la topología deficiente o el exceso de triángulos constituyen comportamiento normal de la generación por IA, remitiendo al operador Remesh como corrección (Meshy, 2026b).
Análisis del pipeline Image-to-3D y AI Texturing: democratización de texturas inteligentes
El módulo Image-to-3D constituye el núcleo tecnológico actual de la plataforma. Admite entradas JPG y PNG con resolución recomendada igual o superior a 512×512, sujeto nítido y fondo simple, ofreciendo eliminación automática de fondo cuando el fondo es complejo (Meshy, 2026c). Los parámetros de control incluyen entrada multivista (frontal, lateral, posterior), Pose Control para modelos humanoides y realce de imagen. La estratificación de modelos es económicamente explícita: Meshy T2 genera activos Smart Topology en aproximadamente dos segundos por 5 créditos; Meshy T1 se conserva por compatibilidad a 20 créditos y unos tres minutos; y el Ultra Mode de Meshy 7 produce geometría de mayor precisión de forma nativa —no por adición de detalle a un modelo terminado— por 25 créditos (Meshy, 2026c). Esta distinción entre precisión nativa y refinamiento a posteriori es técnicamente sustantiva, pues determina si el detalle superficial es consistente con la topología subyacente o meramente superpuesto.
Figura 4
Correspondencia entre imagen de entrada y malla texturizada en el módulo Image-to-3D
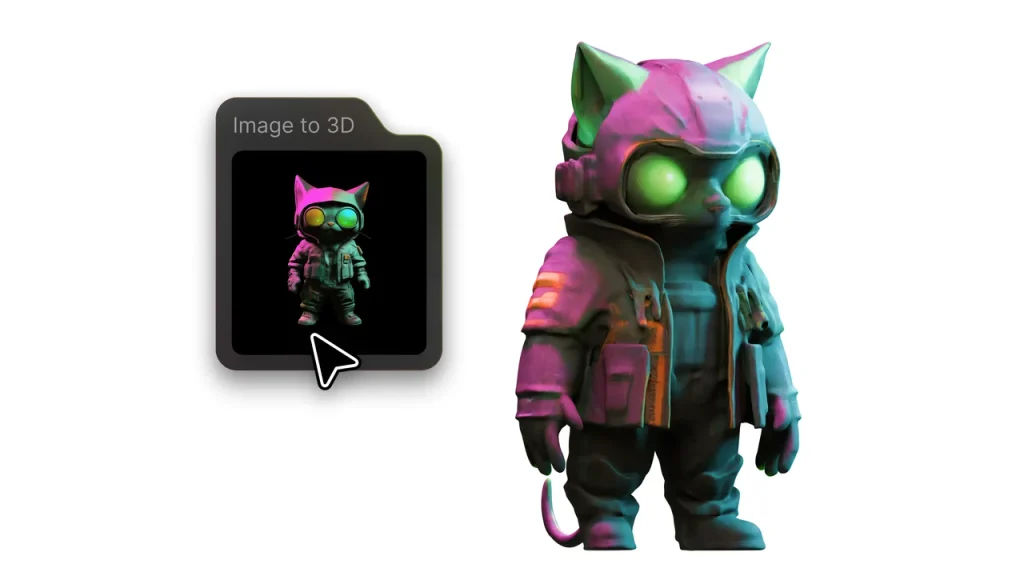
Nota. La comparación permite evaluar la alineación entre entrada y resultado en proporción general, distribución espacial y detalle de superficie, criterio con el que la documentación caracteriza a Meshy 7. Obsérvese que el sombreado del personaje queda adherido al albedo, condición que la función Remove Lighting corrige para restituir la separación entre material y luz (Meshy, 2026c, 2026d). De Meshy AI: Free AI 3D model generator, por Meshy, 2026f (https://www.meshy.ai). Copyright 2026 por Meshy.
El módulo AI Texturing desacopla la síntesis de apariencia de la generación de forma, permitiendo texturizar mallas propias o generadas. Produce conjuntos PBR completos de cuatro mapas Albedo, Normal, Roughness y Metallic con resoluciones de 2K, 4K y 8K, e incorpora una función Remove Lighting que elimina la iluminación horneada en la textura para garantizar un renderizado físicamente correcto bajo cualquier entorno de iluminación (Meshy, 2026d). Este último detalle merece énfasis analítico: la difusión 2D tiende a sintetizar sombreado adherido al albedo, lo que rompe la separación entre material y luz exigida por los pipelines PBR modernos; la deslumbración explícita constituye por tanto una corrección de correctitud física, no un ajuste estético.
La documentación reconoce con inusual franqueza el eslabón débil del proceso: cuando el modelo presenta UV solapadas o de baja calidad, el resultado exhibe costuras y distorsión visibles, y la solución prescrita es ejecutar Unwrap UV antes de reaplicar el texturizado (Meshy, 2026d). La parametrización UV sigue siendo, en consecuencia, un punto crítico no completamente resuelto por la automatización.
Flujo de trabajo práctico e integración con motores de renderizado estándar
La utilidad industrial de un generador 3D depende menos de la fidelidad visual que de su interoperabilidad. Meshy declara más de trece integraciones activas, con plugins nativos para Blender, Unity, Unreal Engine, Maya y ZBrush, nodos nativos en ComfyUI, integración con Omniverse mediante escenarios OpenUSD, envío de activos GLB a Roblox Creator Hub, una API REST completa, un servidor MCP para agentes de IA y una interfaz de línea de comandos (meshy-cli) apta para scripts de shell y pipelines de integración continua (Meshy, 2026e).
La matriz de exportación evidencia una segmentación deliberada por dominio de uso: GLB para web, AR e intercambio universal con texturas embebidas; FBX para Unity, Unreal y herramientas DCC con texturas en archivos separados; OBJ para flujos heredados; STL para impresión 3D (solo geometría); USDZ para AR Quick Look de Apple; y 3MF para impresión 3D en color (Meshy, 2026a). La transferencia de un clic hacia herramientas DCC sin descarga ni importación manual y la capacidad de transportar mallas sin texturizar, modelos con PBR y animaciones riggeadas configuran un flujo de trabajo canónico: generación en Meshy, remallado y ajuste de UV, texturizado PBR, rigging o animación, y exportación al motor destino con asignación de materiales, colisiones y etiquetas semánticas.
Casos de uso industrial: videojuegos, cinematografía, XR e impresión 3D
En videojuegos, la propuesta de valor se concentra en la producción masiva de props secundarios y en la prototipación de niveles (greyboxing texturizado); el modo Smart Topology, con menor recuento de caras y latencia de segundos, está explícitamente orientado a este dominio (Meshy, 2026b, 2026c).
Figura 5
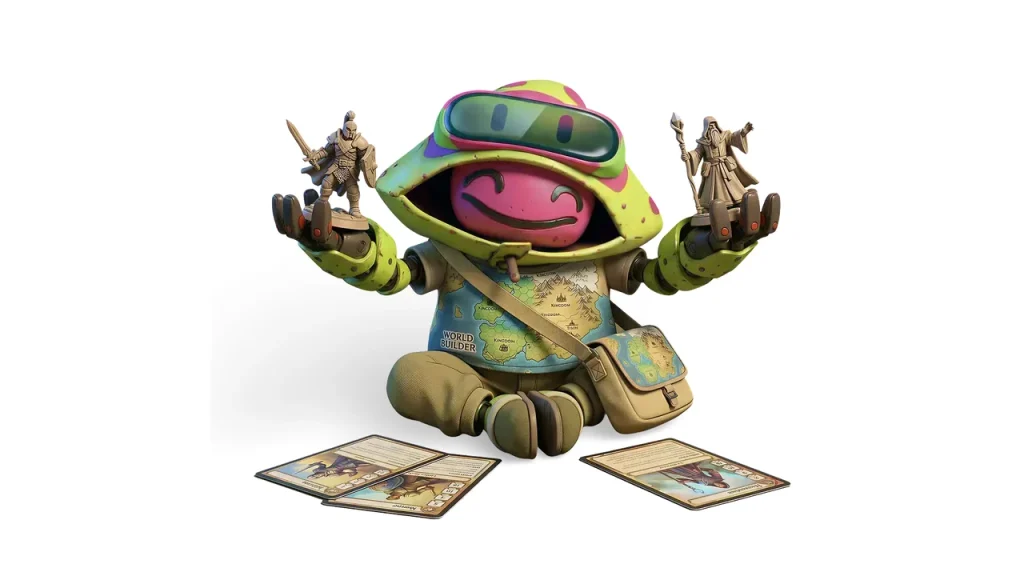
Activos generativos aplicados a producción de juego: personaje, miniaturas y material impreso
En cinematografía y animación, el uso predominante es la preproducción: exploración de concept art volumétrico, previsualización y dressing de fondos, donde la tolerancia a imperfecciones topológicas es alta porque el activo no requiere deformación anatómica exigente ni pasa por look development final.
En realidad virtual y aumentada, la exportación GLB y USDZ con texturas embebidas alinea la plataforma con los formatos estándar de la web inmersiva y del ecosistema Apple, mientras que el presupuesto poligonal reducido resulta crítico dado el doble renderizado estereoscópico.
En impresión 3D, Meshy incorpora un módulo específico que conduce del modelo generado a un archivo listo para impresión, con soporte STL para geometría y 3MF para impresión en color, además de envío directo a software de slicing (Meshy, 2026a, 2026e). La documentación señala asimismo que Meshy 7 resuelve letras grabadas y relieves con limpieza suficiente para grabado CNC y láser (Meshy, 2026c), lo que extiende su aplicabilidad hacia manufactura sustractiva.
Estudio comparativo: ventajas y limitaciones frente a Spline AI, Tripo3D y Luma AI
Spline AI no compite en el mismo eje. Es un entorno de diseño 3D e interactivo basado en navegador cuya funcionalidad generativa es un módulo dentro de un editor orientado a publicación web, iOS y Android sin código; de manera reveladora, delega la generación en motores de terceros seleccionables Hunyuan3D por defecto, Hunyuan 3.1 Pro, Trellis 2 y Meshy y permite conmutar entre resultados sin consumo adicional de créditos (Spline, 2026). Su ventaja es la interactividad y el despliegue; su limitación, la dependencia de modelos externos.
Tripo3D es el competidor más directo en el eje generativo. Su linaje académico es público mediante TripoSR (Tochilkin et al., 2024), lo que le otorga trazabilidad metodológica superior a la de Meshy, y su oferta comercial declara mallas densas de alto recuento poligonal, remallado quad inteligente, entrada multivista, texturas PBR y segmentación de partes. Su documentación técnica sobre “triangle soup” y flujos de retopología (Tripo AI, 2026) evidencia además una estrategia de posicionamiento centrada en la calidad de malla.
Luma AI, con Genie 1.0, fue pionera en abordar frontalmente el problema topológico: anuncia generación en menos de diez segundos con materiales, retopología de malla quad y recuento poligonal variable en formatos estándar exportables a Blender, Unity y Unreal (Luma AI, 2024). Sin embargo, su desarrollo estratégico se ha desplazado hacia generación de vídeo y captura neuronal, lo que ha ralentizado la iteración del producto 3D.
En síntesis, las ventajas comparativas de Meshy son la amplitud del ecosistema de integración (plugins nativos, MCP, CLI, CI), la profundidad del módulo de texturizado PBR con mapas de 8K y deslumbración, la cobertura del ciclo completo hasta impresión y animación, y la granularidad económica de sus modos de calidad. Sus limitaciones son la opacidad arquitectónica ausencia de publicaciones revisadas por pares, parámetros o datasets, la dependencia de operadores correctivos (Remesh, Unwrap UV) para alcanzar estándares profesionales de topología, la naturaleza propietaria y no reproducible del modelo, y un régimen de créditos que introduce costo marginal por iteración en flujos exploratorios.
Consideraciones éticas, desafíos en la topología de malla y el futuro del diseño 3D asistido por IA
El desafío técnico central no es la fidelidad de la forma, sino la calidad de la topología. Los métodos de reconstrucción producen, por construcción, superficies extraídas de campos implícitos mediante marching cubes o algoritmos equivalentes: mallas triangulares densas, sin flujo de aristas, con posibles aristas no-manifold y huecos —lo que la literatura práctica denomina triangle soup—, inadecuadas para deformación esquelética, subdivisión o modelado posterior (Tripo AI, 2026). La respuesta más prometedora del campo consiste en tratar la extracción de malla como un problema generativo: MeshAnything emplea un VQ-VAE para aprender un vocabulario de mallas y un transformer decoder-only condicionado por la forma para generar autoregresivamente Artist-Created Meshes, alcanzando precisión comparable con cientos de veces menos caras y mejoras consiguientes en eficiencia de almacenamiento, renderizado y simulación (Chen et al., 2024). La existencia de modos como Smart Topology sugiere que la industria comercial converge hacia ese mismo principio, aunque sin verificación pública de la proporción de quads ni de la coherencia de los edge loops.
Figura 6
Activo de estilo estilizado con superficies planas y flujo de aristas legible
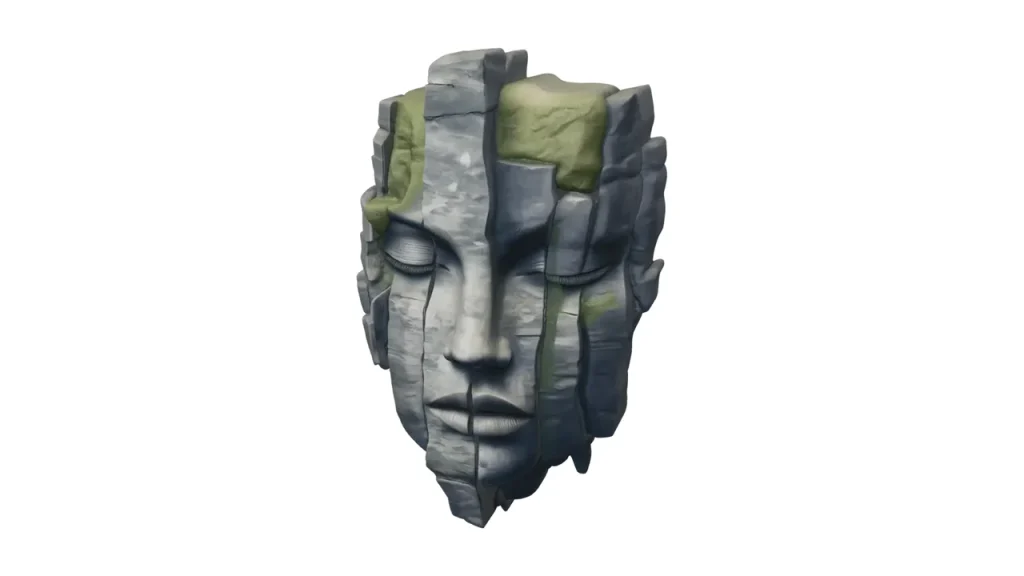
Nota. Los volúmenes facetados y las superficies amplias de este registro estilístico producen topología más limpia que los descriptores fotorrealistas, consistentes con lo reportado por la documentación de la plataforma y con el principio que orienta modos como Smart Topology (Meshy, 2026b). El contraste con la Figura 1 ilustra la tensión entre densidad de detalle y gobernabilidad de la malla. De Meshy AI: Free AI 3D model generator, por Meshy, 2026f (https://www.meshy.ai). Copyright 2026 por Meshy.
En el plano ético y jurídico, la cuestión determinante es la procedencia de los datos. El entrenamiento de modelos 3D a escala depende de corpus como Objaverse-XL, con más de diez millones de objetos agregados desde múltiples fuentes (Deitke et al., 2023), cuya heterogeneidad de licencias plantea problemas no resueltos de atribución y consentimiento. La Oficina de Derechos de Autor de Estados Unidos ha sostenido que los pesos de un modelo reflejan patrones aprendidos de los datos de entrenamiento y pueden retener elementos protegidos, lo que sitúa el uso justo de dichos corpus en terreno disputado (U.S. Copyright Office, 2025). En el caso de plataformas propietarias que no divulgan su dataset, el usuario final asume un riesgo de trazabilidad que no puede auditar. A ello se suman efectos laborales sobre el modelado de activos de baja complejidad y un riesgo de homogeneización estética derivado de la convergencia sobre los mismos corpus y los mismos priores de difusión.
Prospectivamente, cabe anticipar tres vectores: la generación nativa de mallas de calidad artística que elimine la etapa de retopología; la generación composicional de escenas completas con jerarquía semántica, materiales y propiedades físicas dirección ya sugerida por la integración con OpenUSD y la asignación de colisiones y etiquetas semánticas (Meshy, 2026e); y la orquestación agéntica del pipeline mediante protocolos como MCP, que reposiciona al artista como director de un sistema generativo antes que como ejecutor de geometría. La conclusión analítica es que Meshy AI no sustituye la competencia técnica en computación gráfica: la desplaza desde la construcción manual de polígonos hacia la evaluación crítica, la corrección topológica y la integración de activos sintéticos en pipelines de producción rigurosos.
Creditos
Autor: Juan Felipe Garavito Feo y Juan Fernando Fonseca Martinez
Editor: Magister Ingeniero Carlos Ivan Pinzon
Código: UCIAT_8
Universidad: Universidad Central
Fuentes:
Chen, Y., He, T., Huang, D., Ye, W., Chen, S., Tang, J., Chen, X., Cai, Z., Yang, L., Yu, G., Lin, G., & Zhang, C. (2024). MeshAnything: Artist-created mesh generation with autoregressive transformers (arXiv:2406.10163). arXiv. https://doi.org/10.48550/arXiv.2406.10163
Deitke, M., Liu, R., Wallingford, M., Ngo, H., Michel, O., Kusupati, A., Fan, A., Laforte, C., Voleti, V., Gadre, S. Y., VanderBilt, E., Kembhavi, A., Vondrick, C., Gkioxari, G., Ehsani, K., Schmidt, L., & Farhadi, A. (2023). Objaverse-XL: A universe of 10M+ 3D objects (arXiv:2307.05663). arXiv. https://arxiv.org/abs/2307.05663
Hong, Y., Zhang, K., Gu, J., Bi, S., Zhou, Y., Liu, D., Liu, F., Sunkavalli, K., Bui, T., & Tan, H. (2023). LRM: Large reconstruction model for single image to 3D (arXiv:2311.04400). arXiv. https://arxiv.org/abs/2311.04400
Kerbl, B., Kopanas, G., Leimkühler, T., & Drettakis, G. (2023). 3D Gaussian splatting for real-time radiance field rendering. ACM Transactions on Graphics, 42(4), 1–14. https://doi.org/10.1145/3592433
Luma AI. (2024). Luma Genie 1.0. https://www.luma-ai.com/luma-genie-1-0/
Meshy. (2026a). Meshy documentation: AI 3D model generator from text and image. Meshy Docs. https://docs.meshy.ai/en
Meshy. (2026b). Text to 3D: Generate 3D models from prompts. Meshy Docs. https://docs.meshy.ai/en/webapp/text-to-3d
Meshy. (2026c). Image to 3D: Convert photos into 3D models. Meshy Docs. https://docs.meshy.ai/en/webapp/image-to-3d
Meshy. (2026d). AI Texturing: PBR textures for any 3D model. Meshy Docs. https://docs.meshy.ai/en/webapp/guides/3d-model/ai-texturing
Meshy. (2026e). 3D plugins and MCP integrations for Blender, Unity, Unreal and more. https://www.meshy.ai/integrations
Meshy. (2026f). Meshy AI: Free AI 3D model generator [Galería de modelos generados]. https://www.meshy.ai
Poole, B., Jain, A., Barron, J. T., & Mildenhall, B. (2022). DreamFusion: Text-to-3D using 2D diffusion (arXiv:2209.14988). arXiv. https://arxiv.org/abs/2209.14988
Spline. (2026). AI 3D generation. Spline Docs. https://docs.spline.design/generate/ai-3d-generation
Tencent Hunyuan3D Team. (2025). Hunyuan3D 2.0: Scaling diffusion models for high resolution textured 3D assets generation (arXiv:2501.12202). arXiv. https://arxiv.org/abs/2501.12202
Tochilkin, D., Pankratz, D., Liu, Z., Huang, Z., Letts, A., Li, Y., Liang, D., Laforte, C., Jampani, V., & Cao, Y.-P. (2024). TripoSR: Fast 3D object reconstruction from a single image (arXiv:2403.02151). arXiv. https://doi.org/10.48550/arXiv.2403.02151
Tripo AI. (2026). Fixing AI 3D triangle soup: A production-ready retopology workflow. https://www.tripo3d.ai/media-production/fix-ai-3d-triangle-soup
U.S. Copyright Office. (2025). Copyright and artificial intelligence, part 3: Generative AI training (Pre-publication version). Library of Congress. https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-3-Generative-AI-Training-Report-Pre-Publication-Version.pdf