LLM: La Inteligencia que Aprendió a Hablar Como Nosotros
Que es un LLM y por qué es tan importante
Un modelo de lenguaje es un sistema que calcula la probabilidad de que una palabra o token aparezca después de una secuencia dada. Cuando ese sistema se construye con arquitecturas de miles de millones de o incluso billones de parámetros y se entre con miles de millones de fragmentos de texto extraídos de internet o libros y código, se convierte en lo que hoy llamamos un LLM. la diferencia frente a un modelo de lenguaje clásico no es solo de tamaño, los LLM manejan ventanas de contexto de millones de tokens, generan texto coherente en párrafos párrafos completos y muestran habilidades que no se les enseñaron explícitamente, como resolver una tarea nueva con apenas un par de ejemplos en el propio mensaje. (Harvard Business School Online, 2026). Su relevancia radica en que unificaron, bajo un mismo mecanismo de predicción de la siguiente palabra, tareas que antes requerían sistemas separados traducir, resumir, responder preguntas, clasificar documentos o generar código. Mientras los modelos estadísticos tradicionales, basados en N- gramas o los modelos recurrentes limitaban su contexto a unas pocas palabras anteriores, los LLM actuales, construidos sobre la arquitectura Transformer, logran sostener esas ventanas de contexto amplias y ese comportamiento de few – shot learning.(Harvard Business School Online, 2026).
Evolución histórica de los N-gramas a los Transformers
El desarrollo de los Modelos de lenguaje a gran escala (LLM) son el resultado de décadas de investigación recolectada en modelado de lenguaje. Inicialmente los modelos n-grama inspirados en los trabajos de Shannon y Markov (Matemáticos que dieron origen a la teoría de informacion y analisis de procesos aleatorios) estimaban probabilidades a partir de frecuencias de secuencias cortas sin capturar significado semántico profundo (Harvard Business School Online, 2026). Con la llegada de las redes neuronales surgieron embeddings y posteriormente las redes neuronales y sus variantes LSTM que lograban procesar el texto de manera secuencial pero con limitaciones y pérdida de información en secuencias largas. En 2017 se incorporó la arquitectura Transformer basada en mecanismos de atención, para 2018 se popularizó el pre entrenamiento bidireccional para tareas de comprensión (Devlin et al., 2018). Y en 2020 Chat GPT-3 con 175 mil millones de parámetros evidencio capacidades emergentes de aprendizaje con pocos ejemplos(Brown et al., 2020). Lo anterior permitió el ajuste por instrucciones y la retroalimentación humana dando origen a sistemas conversacionales en la actualidad los modelos poseen ventanas de contexto de hasta diez millones de tokens y arquitecturas de mezcla de expertos que optimizan la eficiencia computacional.(Moflo.ai, 2026).
Arquitectura Transformer y Mecanismos de atención
La arquitectura Transformer es la base sobre la que se construyen prácticamente todos lo LLM actuales, y su gran aporte fue dejar atrás la recurrencia para apostar por un mecanismo llamado autoatención o self – attention. Debido a esto cada palabra de una oración puede mirar a todas las demás al mismo tiempo, sin importar que tan lejos estén de una de otra, lo que permite al modelo captar relaciones de sentido y de gramática que antes se perdían.(Vaswani et al., 2017). Esta cambio de enfoque también trajo una ventaja práctica enorme al no depender del procesar el texto palabra por palabra en orden, el entrenamiento se puede hacer en paralelo, lo que aceleró, el entrenamiento se puede hacer en paralelo, lo que aceleró los tiempos y abrió la puerta a modelos de un tamaño que antes era irrealizable.
Así es como el texto avanza por dento del modelo, primero se parte en fragmentos pequeños llamados tokens, cada uno de esos tokens se transforma en un vector numérico, luego se le agrega información sobre su posición dentro de la frase el positional encoding, es necesario ya que a diferencia de una persona leyendo, el Transformes no tiene una noción natural de que va antes o después. Con la información lista el texto pasa por varias capas de atención y de redes que van refinando poco a poco la interpretación del contexto. (Harvard Business School Online, 2026). No todos los modelos usan esta arquitectura de la misma manera los tipos encoder, como BERT, están pensados para comprender el texto leyéndolo en ambas direccionada a la vez
El Proceso de Entrenamiento: Preentrenamiento, Ajuste Fino y Alineación
El entrenamiento de un LLM implica varias etapas en donde se inicia con el preentenamiento que consiste en exponer al modelo a enormes cantidades de información escrita mediante páginas web, libros, foros, y repositorios de código esto con el fin de que aprenda de forma autosupervisada sin etiquetas humanas: se le muestra un fragmento de texto al que le falta la siguiente palabra, y el modelo intenta adivinarla. Si se equivoca, ajusta internamente sus parámetros para acercarse más la próxima vez y este ciclo se repite miles de millones de veces lo que representa inversiones muy altas en computación y energía. Luego de esta etapa el modelo pasa al ajuste fino en dominios específicos mediante el cual se le entrena con pares de instrucción y respuesta deseada para que siga órdenes humanas con mayor precisión (Ouyang et al., 2022). Para posteriormente pasar a la alineación del modelo que se da mediante el aprendizaje por refuerzo a través de la retroalimentación humana con las preferencias de las personas en donde se generan varias respuestas a un mismo estímulo y evaluadores humanos las clasifican por calidad, y esa es la señal que ajusta el modelo mediante el aprendizaje por refuerzo.
Capacidades emergentes y aprendizaje en Contexto
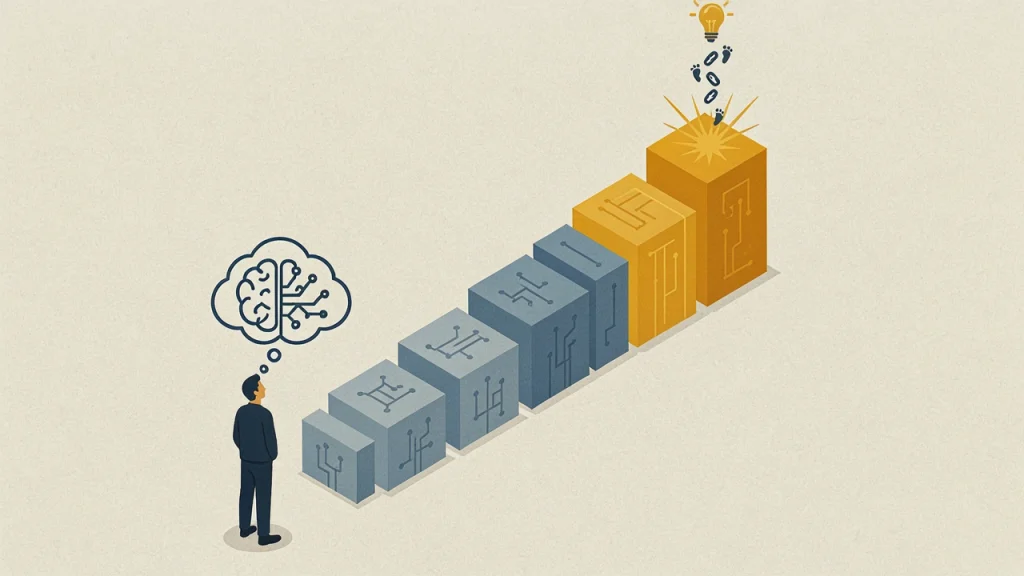
Uno de los acontecimientos más estudiados en LLM es la aparición de capacidades emergentes, habilidad que no se observa en modelos pequeños, pero que surgen al incrementar el número de parámetros datos de entrenamiento (Yucas.net, 2026). Las que más destacan el aprendizaje en contexto, que permite resolver tareas nuevas a partir de unos ejemplos incluidos el mensaje de entrada, y el razonamiento en cadena en el que el modelo mejora su desempeño generando pasos intermedios antes de la respuesta final.
La relación entre escala y desempeño se documenta en las llamadas leyes de escalamiento, que muestran cómo el rendimiento mejora de forma sistemática al aumentar el número de parámetros, los datos y la capacidad computacional del entrenamiento (Yucas.net, 2026). Permanece un debate científico sobre la naturaleza de estas capacidades mientras algunos investigadores sostienen que el refrán es una forma genuina de razonamiento. otros argumentan que se trata de patrones estadísticos sofisticados sin compresión real del lenguaje, discusión que continúa abierta en la literatura especializada (PMC/NIH, 2026).
Principales modelos y empresas desarrolladoras en 2026
En la actualidad el panorama de los LLM está marcado por una intensa competencia entre sistemas propietarios y de pesos abiertos. Para los modelos cerrados accesibles únicamente a través de interfaz o API se destacan las familias GPT de Open AI, tambien Claude de Anthropic y Gemini de Google, las cuales incorporan ventanas de contexto de hasta un millón de tokens y capacidades multimodales de texto, imagen y video.
Por otra parte los modelos de pesos abiertos como lo son Llama de Meta, DeepSeek de Alibaba permite a las universidades a los desarrolladores independientes y las pequeñas empresas descargar, personalizar, y ejecutar sus propios modelos con arquitecturas de mezcla de expertos que activan sólo una fracción de sus parámetros por consulta, logrando la optimización del costo computacional. (Moflo.ai, 2026).
Conviene enfatizar la diferencia presente entre los pesos abiertos y el código abierto; ya que en los pesos abiertos están disponibles para descarga únicamente los parámetros entrenados y para el código abierto además de los parámetros entrenados se publica el código de entrenamiento y los datos utilizados lo cual resulta poco frecuente en los modelos de mayor escala, por lo cual las organizaciones con distintos presupuestos y necesidades pueden elegir el modelo que mejor se ajuste a su caso.
Aplicaciones ,ventajas y limitaciones de los LLM
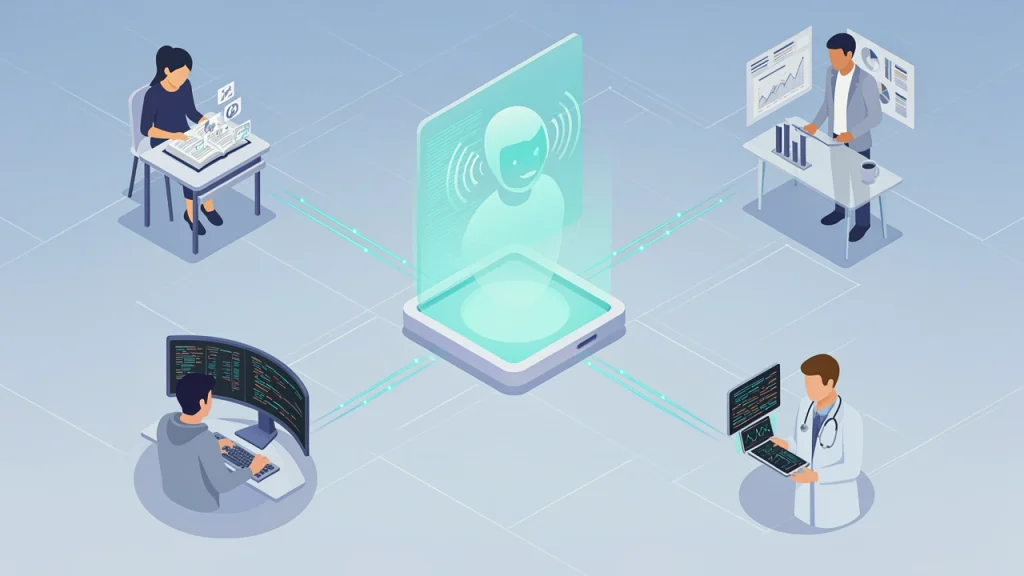
Las aplicaciones de los LLM abarcan prácticamente todos los sectores en educación, apoyo tutorías personalizadas, en empresa donde automatizan informes y análisis documental en programación, general y depuran código y en medicina finanzas asisten en la síntesis de la información sin sustituir el juicio profesional (Harvard Business School Online, 2026). Entre los beneficios se cuentan el aumento de productividad, la accesibilidad al conocimiento complejo explicado en el lenguaje sencillo y la capacidad de adaptar respuestas al contexto del usuario.
Estas ventajas conviven con limitaciones importantes las más documentada es la generación de contenido pero factualmente falso, que ocurre porque el modelo optimiza la probabilidad estadística el siguiente token y no la veracidad de su afirmaciones (Harvard Business School Online, 2026). A esto se suma el desconocimiento de información posterior a la fecha de corte mitigable mediante generación aumentada por recuperación (EICTA IITK, 2026), la vulnerabilidad ante manipulaciones del mensaje de entrada y preocupaciones sobre la privacidad de derechos de autor y consumo energético
Ética, y perspectivas futuras
El uso creciente de los modelos de lenguaje a gran escala representa interrogantes éticos que trascienden lo técnico, debido a la falta transparencia de los modelos cerrados y la dificultad para explicar su razonamiento interno, además del debate legal sobre el uso del material protegido por derechos de autor durante el entrenamiento y la responsabilidad a la desinformación. Razón por la cual existen iniciativas como la ley de la de Inteligencia Artificial de la Unión Europea y los principios de la OCDE y la UNESCO que buscan marcos reglamentarios proporcionales para cada aplicación.
La evidencia disponible en 2026 denota que un LLM ya no se limita sólo a responder una pregunta en cambio puede actuar como un asistente autónomo que planifica tareas en varios pasos, en las cuales el modelo te da informacion, divide la tarea en subpasos y los ejecuta en orden lógico sin que debas pedir los pasos por separado, además el modelo usa herramientas externas de forma autónoma decidiendo cuándo buscar en internet, consultar una calculadora, ejecutar código, acceder a una base de datos en lugar de limitarse a lo que “sabe” internamente así tomando decisiones intermedias sin supervisión constante. Por lo cual se han vuelto una pieza fundamental del funcionamiento diaria en empresas, universidades, en el gobierno similar al uso del internet en consecuencia el desarrollo responsable dependerá de equilibrar innovación con transparencia, sostenibilidad pues el consumo energético y de recursos debe ser manejable y no generar un impacto ambiental desproporcionado y también la supervisión humana puesto que siempre debe ser verificado y validado especialmente en decisiones de alto impacto.
Créditos
Autor: Maira Alejandra Acuña Rodriguez y Erika Alejandra Silva Segura
Editor: Mg. Ingeniero Carlos Iván Pinzón Romero
Código: UCIAT-7
Universidad: Universidad Central
Fuentes:
Brown, T., et al. (2020). Language Models are Few-Shot Learners (GPT-3). Arxiv. https://arxiv.org/abs/2005.14165
Devlin, J., et al. (2018). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Arxiv. https://arxiv.org/abs/1810.04805
EICTA IITK (2026). Retrieval Augmented Generation (RAG): How It Works and Why It Matters. https://www.eicta.iitk.ac.in/knowledge-hub/artificial-intelligence/retrieval-augmented-generation
Harvard Business School Online (2026). What Are Large Language Models (LLMs) & How Do They Work?.https://online.hbs.edu/blog/post/what-are-llms
Magnific. (2026). Magnific AI image generator [Generador de imágenes con IA]. https://www.magnific.com/ai/image-generator
Moflo.ai (2026). The Best LLMs in 2026: Every Model Compared.Moflo. https://moflo.ai/blog/best-llms-2026
Ouyang, L., et al. (2022). Training Language Models to Follow Instructions with Human Feedback. Arxiv. https://arxiv.org/abs/2203.02155
PubMed Central / National Library Of Medicine (2025–2026). Will multimodal large language models ever achieve deep understanding? https://pmc.ncbi.nlm.nih.gov/articles/PMC12679578/